vi
 en
 ja


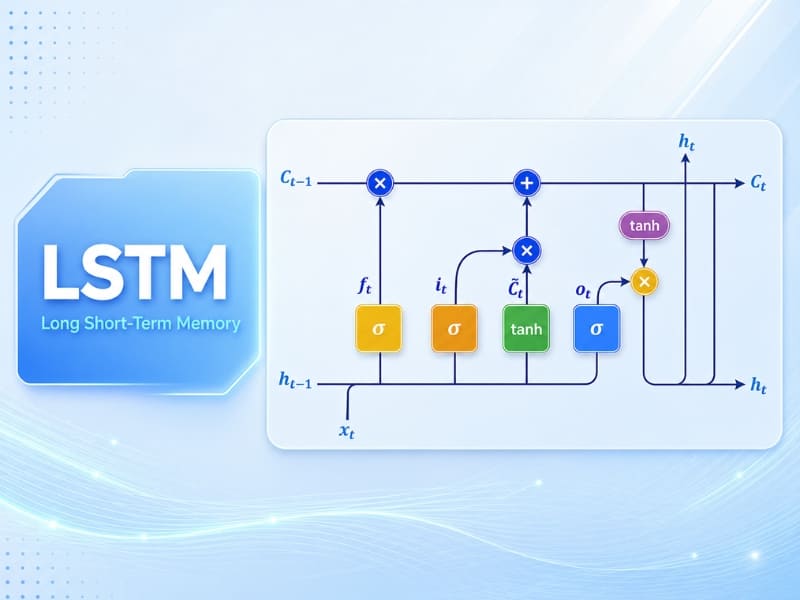
Việc xử lý dữ liệu tuần tự đóng vai trò quan trọng trong nhiều bài toán như xử lý ngôn ngữ tự nhiên, nhận dạng giọng nói và dự báo chuỗi thời gian. Long Short-Term Memory (LSTM) là một kiến trúc mạng nơ-ron hồi quy thuộc Deep Learning, được thiết kế để ghi nhớ thông tin quan trọng trong chuỗi dữ liệu và hạn chế vấn đề mất thông tin dài hạn của RNN truyền thống. Cùng FPT.AI tìm hiểu LSTM là gì, cấu trúc, nguyên lý hoạt động và những ứng dụng nổi bật của mô hình này trong các hệ thống AI hiện đại.
Long Short-Term Memory (LSTM) là gì?
Long Short-Term Memory (LSTM – Bộ nhớ dài-ngắn hạn) là một kiến trúc mạng nơ-ron hồi quy chuyên biệt, thuộc họ Recurrent Neural Network (RNN), được thiết kế để học và ghi nhớ các phụ thuộc dài hạn trong dữ liệu tuần tự.
Mô hình được đề xuất bởi Sepp Hochreiter và Jürgen Schmidhuber vào năm 1997. Mục đích ra đời của LSTM là giảm thiểu hiện tượng vanishing gradient (tiêu biến gradient), một trong những nguyên nhân khiến RNN truyền thống gặp khó khăn khi học các mối quan hệ giữa những thông tin nằm cách xa nhau trong chuỗi dữ liệu.
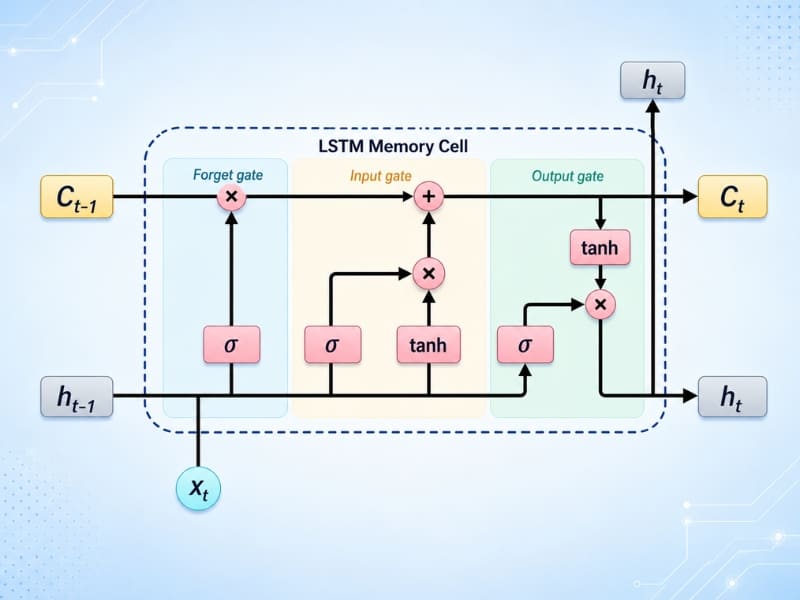
Khác với RNN truyền thống, LSTM sử dụng Cell State (trạng thái bộ nhớ), Hidden State (trạng thái ẩn) cùng hệ thống các cổng điều khiển (Forget Gate, Input Gate và Output Gate) để chọn lọc, lưu giữ hoặc loại bỏ thông tin, giúp mô hình duy trì những thông tin có liên quan qua nhiều bước thời gian và học các phụ thuộc dài hạn hiệu quả hơn RNN cơ bản.
Ví dụ, trong câu “Tôi sinh ra ở Hà Nội, sau đó chuyển đến nhiều thành phố khác để học tập và làm việc. Quê hương của tôi là…”, mô hình cần liên hệ thông tin “Hà Nội” xuất hiện ở đầu câu với phần nội dung phía sau để dự đoán từ phù hợp. LSTM có thể học cách duy trì thông tin về địa điểm này trong trạng thái bộ nhớ qua nhiều bước xử lý, thay vì chỉ dựa vào những từ xuất hiện gần vị trí cần dự đoán.
Nhờ cơ chế này, LSTM có khả năng ghi nhớ các phụ thuộc dài hạn, hạn chế hiện tượng vanishing gradient và xử lý nhiều loại dữ liệu tuần tự trong các bài toán Deep Learning. Mô hình được ứng dụng trong xử lý ngôn ngữ tự nhiên (NLP), hỗ trợ các tác vụ như chatbot, dịch máy và phân loại văn bản.
Cấu trúc cơ bản của mô hình Long Short-Term Memory
LSTM sử dụng Cell State và các cổng điều khiển để ghi nhớ thông tin quan trọng, loại bỏ dữ liệu không cần thiết và duy trì phụ thuộc dài hạn trong chuỗi. Cấu trúc của một đơn vị LSTM (LSTM Cell) gồm hai trạng thái chính là Cell State và Hidden State, kết hợp với ba cổng điều khiển: Forget Gate, Input Gate và Output Gate. Các thành phần này phối hợp để kiểm soát thông tin được lưu trữ, cập nhật và truyền qua từng bước thời gian.>
Cell State và Hidden State
Cell State (trạng thái bộ nhớ) và Hidden State (trạng thái ẩn) là hai thành phần quan trọng giúp LSTM duy trì và xử lý thông tin trong chuỗi dữ liệu. Mặc dù đều mang thông tin từ các bước thời gian trước đó, mỗi trạng thái đảm nhận một chức năng khác nhau:
- Cell State (Cₜ): Đóng vai trò là bộ nhớ dài hạn của LSTM, cho phép thông tin được duy trì qua nhiều bước thời gian. Cell State được cập nhật thông qua Forget Gate và Input Gate, giúp mô hình giữ lại những thông tin cần thiết và bổ sung dữ liệu mới.
- Hidden State (hₜ): Là trạng thái ẩn thể hiện thông tin đầu ra của LSTM tại bước thời gian hiện tại. Hidden State được tạo từ Cell State đã cập nhật dưới sự kiểm soát của Output Gate, sau đó được truyền đến bước thời gian tiếp theo và có thể được sử dụng bởi các tầng mạng phía sau.
Điểm khác biệt chính là Cell State duy trì thông tin trong bộ nhớ, còn Hidden State biểu diễn phần thông tin được sử dụng làm đầu ra tại mỗi bước thời gian. Nhờ kết hợp hai trạng thái, LSTM có thể khai thác ngữ cảnh trước đó mà không phải chỉ dựa vào dữ liệu đầu vào hiện tại.
Cổng quên (Forget Gate)
Forget Gate quyết định thông tin nào trong Cell State được giữ lại hoặc loại bỏ. Cổng sử dụng hàm Sigmoid dựa trên đầu vào hiện tại và Hidden State trước đó để xác định mức độ lưu giữ thông tin. Hàm Sigmoid tạo ra các giá trị từ 0 đến 1 cho từng thành phần của Cell State, trong đó giá trị gần 0 tương ứng với mức độ loại bỏ cao và giá trị gần 1 tương ứng với mức độ giữ lại cao.
Nhờ cơ chế này, Forget Gate giúp LSTM hạn chế lưu giữ những thông tin không còn phù hợp với ngữ cảnh hiện tại, đồng thời duy trì các đặc trưng quan trọng từ những bước thời gian trước.
Cổng đầu vào (Input Gate)
Input Gate kiểm soát thông tin mới được thêm vào Cell State. Nhờ hàm Sigmoid, cổng xác định dữ liệu nào cần được cập nhật và hạn chế lưu những thông tin không cần thiết. Bên cạnh đó, một lớp sử dụng hàm Tanh tạo ra vector thông tin ứng viên (Candidate Cell State), chứa những giá trị mới có thể được bổ sung vào bộ nhớ.
Thông tin ứng viên được kết hợp với kết quả của Input Gate để xác định mức độ cập nhật Cell State. Cơ chế này cho phép LSTM tiếp nhận dữ liệu mới một cách có chọn lọc, tránh việc mọi thông tin đầu vào đều được lưu giữ như nhau.
Cổng đầu ra (Output Gate)
Output Gate quyết định lượng thông tin từ Cell State được sử dụng để tạo Hidden State. Kết quả này được dùng làm đầu ra tại bước hiện tại và truyền sang bước xử lý tiếp theo.
Cụ thể, Output Gate sử dụng hàm Sigmoid để xác định mức độ thông tin được đưa ra từ Cell State đã cập nhật. Trạng thái bộ nhớ được biến đổi qua hàm Tanh, sau đó kết hợp với giá trị của Output Gate để tạo Hidden State. Nhờ đó, LSTM có thể kiểm soát thông tin được truyền đến bước thời gian tiếp theo hoặc các tầng xử lý phía sau.
Nguyên lý hoạt động của Long Short-Term Memory
Long Short-Term Memory (LSTM) xử lý dữ liệu tuần tự thông qua ba cổng chính, giúp mô hình quyết định thông tin nào cần loại bỏ, cập nhật và truyền sang bước tiếp theo. Tại mỗi bước thời gian (t), LSTM tiếp nhận đầu vào hiện tại (xₜ), trạng thái ẩn trước đó (hₜ₋₁) và trạng thái bộ nhớ trước đó (Cₜ₋₁). Quá trình xử lý diễn ra qua 4 bước liên tiếp: xác định thông tin cần quên, chọn lọc thông tin mới, cập nhật Cell State và tạo Hidden State.
Bước 1: Cổng quên (Forget Gate) lọc bỏ thông tin không cần thiết
Forget Gate đánh giá thông tin từ trạng thái trước và đầu vào hiện tại để xác định phần nào nên được giữ lại hoặc loại bỏ khỏi bộ nhớ. Nhờ đó, LSTM hạn chế lưu trữ những dữ liệu không còn hữu ích.
Cụ thể, đầu vào hiện tại (xₜ) và Hidden State trước đó (ht-1) được kết hợp, nhân với ma trận trọng số (Wf) và cộng thêm hệ số điều chỉnh (bf). Kết quả được đưa qua hàm Sigmoid để tạo vector điều khiển (fₜ), với các giá trị nằm trong khoảng từ 0 đến 1:
- Giá trị gần 0: Thông tin tương ứng trong bộ nhớ cũ sẽ bị loại bỏ phần lớn.
- Giá trị gần 1: Thông tin tương ứng được giữ lại gần như nguyên vẹn.
Công thức cổng quên:
fₜ = σ(Wf . [ht-1, xₜ] + bf)
Ví dụ: Trong câu “Tôi sinh ra ở Hà Nội, sau đó chuyển đến nhiều thành phố khác để học tập và làm việc. Quê hương của tôi là…”, LSTM có thể học cách giảm ảnh hưởng của những chi tiết không liên quan đến quê hương, đồng thời duy trì thông tin ngữ cảnh về “Hà Nội”.
Bước 2: Cổng đầu vào (Input Gate) lựa chọn thông tin mới cần ghi nhớ
Input Gate lựa chọn những thông tin mới cần ghi nhớ thông qua hai phép tính phối hợp. Hàm Sigmoid xác định mức độ tiếp nhận thông tin mới, trong khi hàm Tanh tạo ra vector giá trị ứng viên (Candidate Cell State), chứa thông tin có thể được bổ sung vào bộ nhớ.
Công thức cổng đầu vào:
iₜ = σ(Wi . [ht-1, xt] + bi)
Công thức tạo thông tin ứng viên:
C̃ₜ = tanh(Wc . [ht-1, xt] + bc)
Trong đó, iₜ thể hiện mức độ cho phép cập nhật thông tin và C̃ₜ là vector ứng viên có giá trị trong khoảng từ −1 đến 1. Hai kết quả này sẽ được sử dụng để cập nhật Cell State tại bước tiếp theo.
Ví dụ: Khi LSTM xử lý cụm từ “Quê hương của tôi”, cổng đầu vào có thể hỗ trợ ghi nhận ngữ cảnh mới liên quan đến mối quan hệ giữa người nói và địa điểm quê hương, từ đó kết hợp với thông tin đã được duy trì trong bộ nhớ.
Bước 3: Cập nhật trạng thái bộ nhớ (Cell State)
Sau khi xác định thông tin cần giữ lại và thông tin mới cần bổ sung, LSTM cập nhật Cell State bằng cách kết hợp hai thành phần: phần bộ nhớ cũ đã được điều chỉnh bởi Forget Gate và phần thông tin ứng viên được chọn lọc bởi Input Gate.
Công thức cập nhật Cell State:
Ct = ft ⊙ Ct-1 + it ⊙ C̃ₜ
Trong đó:
- fₜ ⊙ Cₜ₋₁: Phần thông tin từ trạng thái bộ nhớ trước được giữ lại sau khi đi qua cổng quên.
- iₜ ⊙ C̃ₜ: Phần thông tin mới được chọn để bổ sung vào bộ nhớ.
- ⊙: Phép nhân theo từng phần tử (element-wise multiplication).
- Cₜ: Trạng thái bộ nhớ mới tại bước thời gian hiện tại.
Cơ chế cộng thông tin cũ và mới giúp tạo ra đường truyền bộ nhớ qua các bước thời gian, góp phần giảm ảnh hưởng của hiện tượng vanishing gradient so với RNN truyền thống. Tuy nhiên, điều này không có nghĩa LSTM loại bỏ hoàn toàn hiện tượng tiêu biến gradient.
Ví dụ: Trong câu văn đang xét, Cell State mới có thể tiếp tục lưu giữ các đặc trưng ngữ cảnh liên quan đến “Hà Nội”, đồng thời tích hợp thông tin mới về “quê hương”. Nhờ vậy, mô hình có thêm cơ sở để xử lý phần tiếp theo của chuỗi.
Bước 4: Cổng đầu ra (Output Gate) tạo Hidden State và truyền thông tin
Trước tiên, cổng đầu ra kết hợp đầu vào hiện tại (xₜ) và Hidden State trước đó (hₜ₋₁), sau đó sử dụng hàm Sigmoid để tính vector điều khiển (oₜ). Tiếp theo, Cell State mới (Cₜ) được biến đổi qua hàm Tanh rồi nhân theo từng phần tử với oₜ để tạo Hidden State hiện tại (hₜ).
Công thức cổng đầu ra:
ot = σ(Wo . [ht-1, xt] + bo)
Công thức tạo Hidden State:
ht = ot ⊙ tanh(C t)
Hidden State (hₜ) được sử dụng làm biểu diễn đầu ra của LSTM tại bước thời gian hiện tại, đồng thời được truyền cùng Cell State (Cₜ) sang bước tiếp theo. Trong các bài toán dự đoán, Hidden State có thể được đưa qua những tầng xử lý bổ sung để tạo kết quả cuối cùng.
Ví dụ: Sau khi xử lý cụm “Quê hương của tôi là…”, Hidden State có thể mang thông tin ngữ cảnh hỗ trợ tầng dự đoán đưa ra xác suất phù hợp cho từ “Hà Nội”. Khả năng dự đoán chính xác còn phụ thuộc vào dữ liệu, kiến trúc và quá trình huấn luyện mô hình.
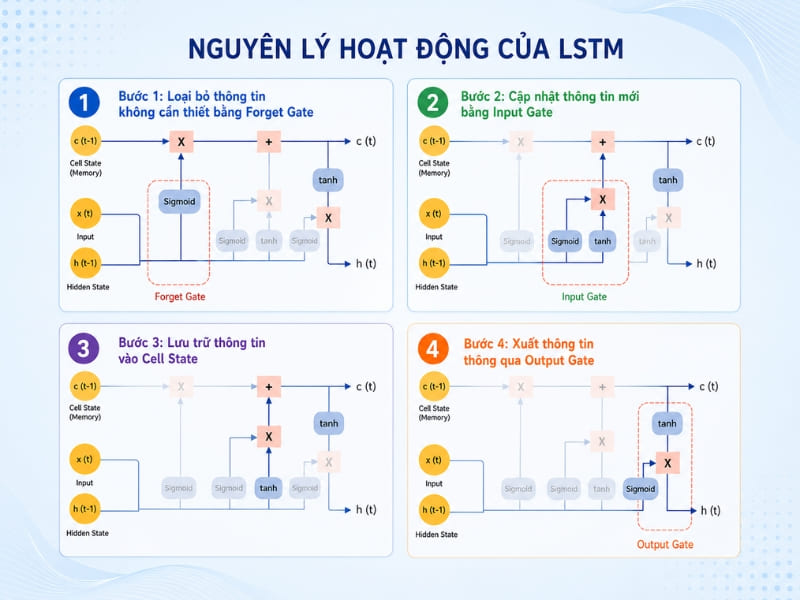
Như vậy, tại mỗi bước thời gian, LSTM thực hiện lần lượt việc chọn lọc thông tin cũ, xác định thông tin mới, cập nhật trạng thái bộ nhớ và tạo trạng thái ẩn. Cơ chế này giúp mô hình học các mối quan hệ trong dữ liệu tuần tự và duy trì thông tin liên quan qua nhiều bước xử lý.
Ưu điểm của Long Short-Term Memory
Nhờ cấu trúc bộ nhớ và các cổng kiểm soát, LSTM mang lại nhiều lợi thế khi xử lý chuỗi dữ liệu:
- Ghi nhớ thông tin dài hạn: Duy trì được các mối liên hệ xuất hiện cách xa nhau trong chuỗi. Nhờ Cell State và các cổng điều khiển, LSTM có thể học cách lưu giữ những thông tin quan trọng qua nhiều bước thời gian, đặc biệt hữu ích trong các bài toán cần khai thác ngữ cảnh trước đó như xử lý ngôn ngữ tự nhiên, nhận dạng giọng nói và dự báo chuỗi thời gian. Tuy nhiên, khả năng ghi nhớ còn phụ thuộc vào độ dài chuỗi, dữ liệu và quá trình huấn luyện.
- Hạn chế vanishing gradient: Giúp quá trình học ổn định hơn so với RNN truyền thống. Cơ chế cập nhật Cell State cho phép thông tin và gradient truyền qua nhiều bước thời gian thuận lợi hơn, giúp giảm nguy cơ tiêu biến gradient khi huấn luyện trên chuỗi dài. Nhờ đó, LSTM thường có khả năng học các phụ thuộc dài hạn tốt hơn RNN cơ bản, dù không loại bỏ hoàn toàn hiện tượng này.
- Xử lý chuỗi linh hoạt: Phù hợp với dữ liệu có độ dài khác nhau như văn bản, âm thanh hay chuỗi thời gian. LSTM có thể xử lý thông tin theo từng bước thời gian và duy trì trạng thái giữa các bước, cho phép mô hình khai thác mối quan hệ theo trình tự của dữ liệu. Chẳng hạn, trong bài toán dự báo nhu cầu tiêu thụ điện, LSTM có thể sử dụng các quan sát trước đó để học những quy luật biến động theo thời gian.
- Lọc thông tin có chọn lọc: Thông qua Forget Gate, Input Gate và Output Gate, LSTM học cách xác định mức độ thông tin cần giữ lại, cập nhật hoặc đưa ra ở mỗi bước thời gian. Cơ chế này giúp mô hình giảm ảnh hưởng của những thông tin ít liên quan và duy trì các đặc trưng có giá trị cho tác vụ dự đoán. Việc chọn lọc được thực hiện thông qua các trọng số học được trong quá trình huấn luyện, thay vì dựa trên những quy tắc cố định.
Hạn chế của mô hình LSTM
Bên cạnh những ưu điểm trên, LSTM cũng có một số hạn chế cần cân nhắc khi triển khai:
- Chi phí tính toán cao: Cấu trúc nhiều cổng khiến mô hình cần nhiều tài nguyên hơn RNN cơ bản. Mỗi đơn vị LSTM phải thực hiện nhiều phép nhân ma trận và phép tính trên các cổng điều khiển, dẫn đến số lượng tham số và chi phí tính toán lớn hơn so với RNN truyền thống có cùng kích thước trạng thái ẩn. Khi triển khai trên tập dữ liệu lớn hoặc thiết bị có tài nguyên hạn chế, doanh nghiệp cần cân nhắc giữa hiệu quả mô hình và chi phí vận hành.
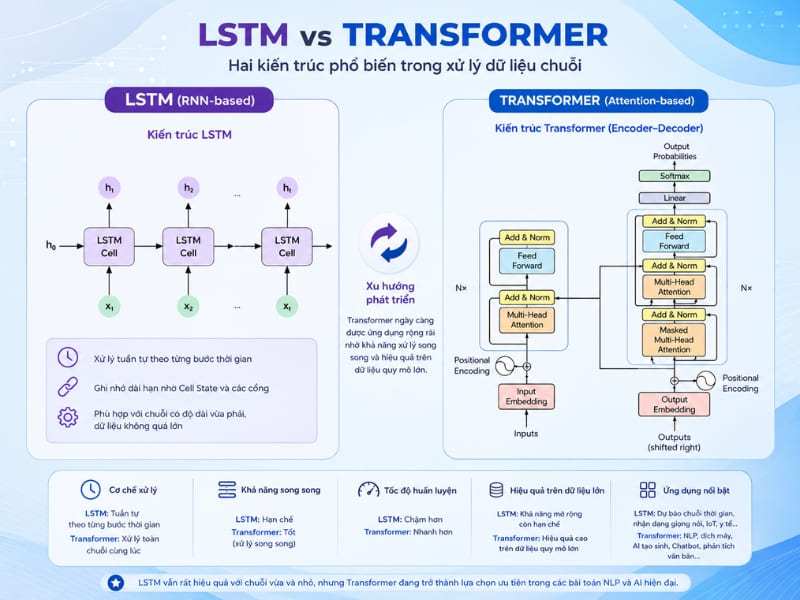
- Thời gian huấn luyện lâu: Quá trình xử lý tuần tự làm giảm khả năng tính toán song song. Do trạng thái tại bước thời gian hiện tại phụ thuộc vào kết quả của bước trước, LSTM khó song song hóa toàn bộ quá trình xử lý theo chiều thời gian. Điều này có thể khiến thời gian huấn luyện kéo dài khi xử lý những chuỗi dữ liệu lớn, đặc biệt so với các kiến trúc hỗ trợ xử lý song song tốt hơn như Transformer.
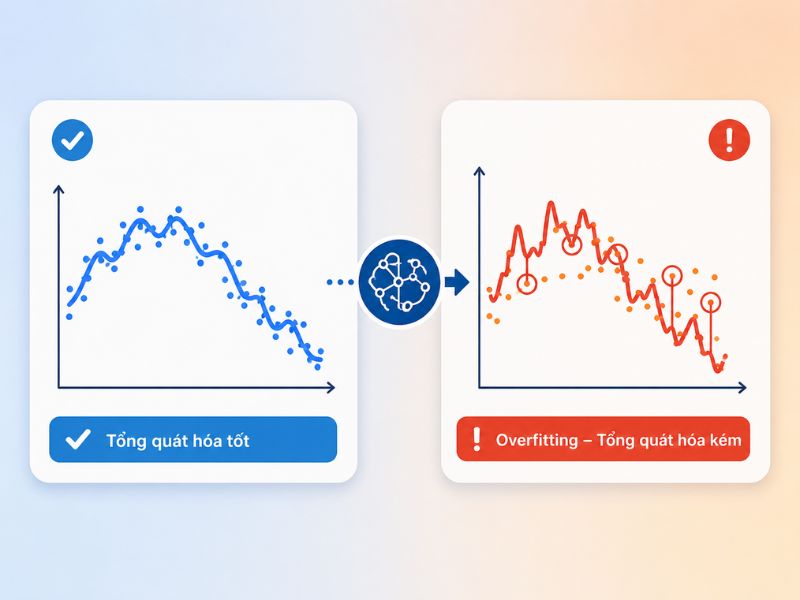
- Dễ overfitting: Có thể học quá sát dữ liệu huấn luyện nếu dữ liệu không đủ hoặc thiếu regularization. Khi mô hình có nhiều tham số nhưng tập dữ liệu huấn luyện nhỏ hoặc thiếu đa dạng, LSTM có nguy cơ ghi nhớ các đặc điểm riêng của dữ liệu huấn luyện thay vì học những quy luật có khả năng khái quát. Có thể hạn chế tình trạng này bằng các kỹ thuật như dropout, regularization và early stopping, kết hợp đánh giá trên tập dữ liệu độc lập.
- Khó tối ưu: Hiệu suất phụ thuộc nhiều vào việc lựa chọn số hidden units, learning rate và độ dài chuỗi. Ngoài ra, số lượng tầng LSTM, batch size và phương pháp tối ưu cũng ảnh hưởng đến khả năng hội tụ và chất lượng dự đoán. Việc lựa chọn cấu hình phù hợp thường đòi hỏi nhiều lần thử nghiệm, đặc biệt với các bài toán có dữ liệu tuần tự phức tạp hoặc chuỗi rất dài.
- Hạn chế về diễn giải (Interpretability): Do thông tin được biểu diễn dưới dạng trạng thái ẩn và các trọng số học được, việc xác định chính xác yếu tố nào dẫn đến một dự đoán cụ thể không phải lúc nào cũng dễ dàng. Đây là vấn đề cần quan tâm trong những lĩnh vực yêu cầu khả năng giải thích cao như tài chính, y tế và các hệ thống hỗ trợ ra quyết định.
Các ứng dụng phổ biến của Long Short-Term Memory
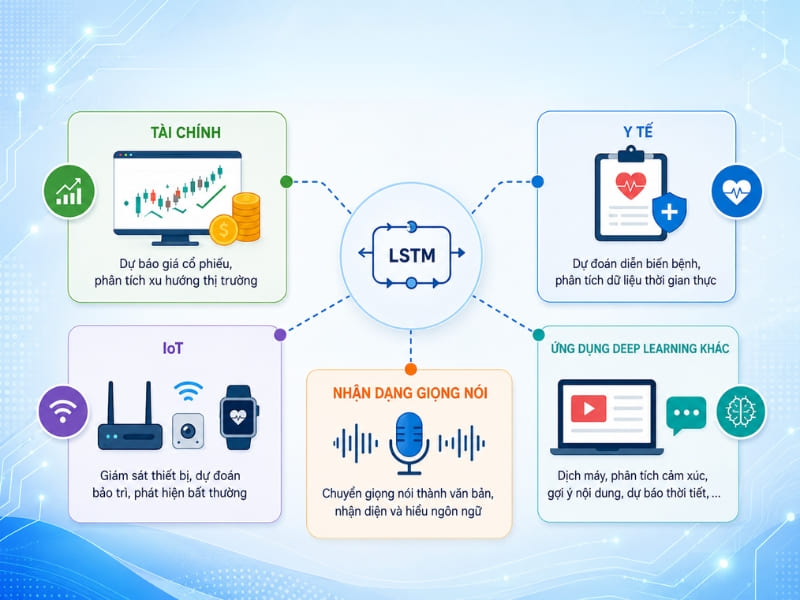
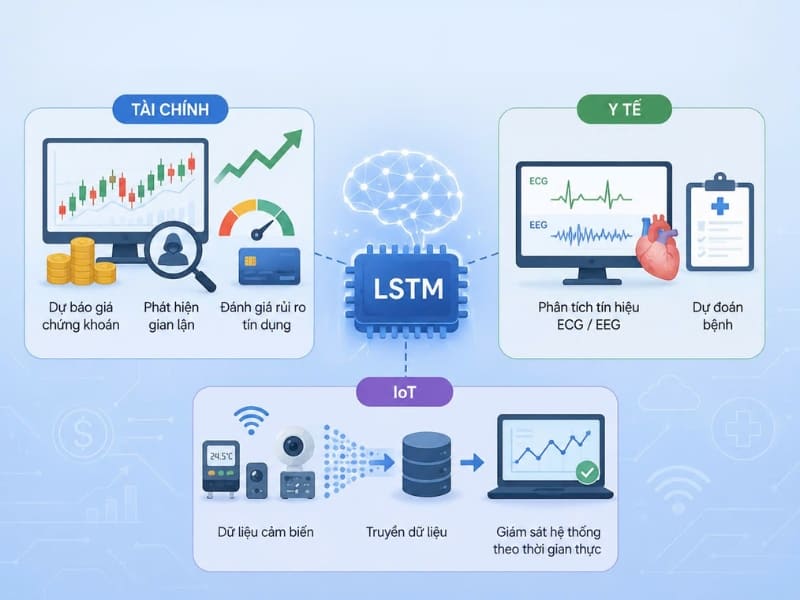
Nhờ khả năng ghi nhớ thông tin dài hạn và xử lý dữ liệu tuần tự, LSTM được ứng dụng trong nhiều bài toán thực tế như:
Xử lý ngôn ngữ tự nhiên
Hỗ trợ dịch máy, phân tích cảm xúc, phân loại và tóm tắt văn bản. LSTM có thể học mối quan hệ giữa các từ xuất hiện ở những vị trí khác nhau trong câu hoặc đoạn văn, giúp mô hình khai thác ngữ cảnh khi xử lý ngôn ngữ. Ví dụ, trong bài toán phân tích cảm xúc, LSTM có thể sử dụng thông tin từ các từ đã xuất hiện trước đó để hỗ trợ xác định sắc thái tích cực, tiêu cực hoặc trung tính của một câu.
Phân tích chuỗi âm thanh để chuyển giọng nói thành văn bản. Phân tích chuỗi âm thanh để chuyển giọng nói thành văn bản. Trong các kiến trúc nhận dạng tiếng nói sử dụng LSTM, mô hình học mối quan hệ theo thời gian giữa các đặc trưng âm thanh, hỗ trợ nhận diện âm vị, từ ngữ và ngữ cảnh lời nói. Chẳng hạn, LSTM có thể xử lý chuỗi đặc trưng âm học của một câu nói để hỗ trợ hệ thống nhận dạng và chuyển đổi thành văn bản tương ứng.
Dự báo chuỗi thời gian
Ứng dụng trong dự báo tài chính, thời tiết, nhu cầu năng lượng và các dữ liệu theo thời gian. LSTM có thể phân tích những quan sát trong quá khứ để học các xu hướng, chu kỳ và mối quan hệ theo thời gian, từ đó hỗ trợ dự báo giá trị trong tương lai. Ví dụ, mô hình có thể sử dụng dữ liệu tiêu thụ điện theo giờ, ngày và các yếu tố liên quan để dự báo nhu cầu điện năng trong những khoảng thời gian tiếp theo. Tuy nhiên, độ chính xác còn phụ thuộc vào chất lượng dữ liệu, biến động thực tế và cách huấn luyện mô hình.
Phân tích video và hình ảnh
Hỗ trợ nhận diện nội dung, hành vi và tạo mô tả cho hình ảnh hoặc video. Khi kết hợp với mạng nơ-ron tích chập (CNN) hoặc mô hình trích xuất đặc trưng hình ảnh, LSTM có thể xử lý chuỗi đặc trưng từ các khung hình liên tiếp để học sự thay đổi của đối tượng theo thời gian. Ví dụ, trong bài toán nhận diện hành động, mô hình có thể phân tích chuỗi khung hình để hỗ trợ phân biệt các hoạt động như đi bộ, chạy hoặc ngồi xuống.
Nhận biết giao dịch gian lận, tấn công mạng hoặc những biến động khác thường trong dữ liệu. LSTM có thể học các mẫu biến động thông thường trong chuỗi thời gian, từ đó hỗ trợ phát hiện những quan sát hoặc hành vi khác biệt đáng kể. Chẳng hạn, trong hệ thống giám sát thiết bị công nghiệp, mô hình có thể phân tích dữ liệu cảm biến theo thời gian để phát hiện các dấu hiệu bất thường về nhiệt độ, áp suất hoặc độ rung, hỗ trợ cảnh báo sớm nguy cơ sự cố.
Hệ thống gợi ý
Phân tích hành vi theo thời gian để cá nhân hóa nội dung, sản phẩm hoặc dịch vụ. LSTM có thể khai thác trình tự tương tác của người dùng, chẳng hạn như lịch sử xem sản phẩm, nhấp chuột hoặc truy cập nội dung, nhằm hỗ trợ dự đoán nhu cầu tiếp theo. Ví dụ, trên nền tảng thương mại điện tử, mô hình có thể phân tích chuỗi sản phẩm người dùng đã xem để đề xuất những sản phẩm có khả năng phù hợp với sở thích hoặc nhu cầu hiện tại.
Phân tích dữ liệu y tế
Xử lý tín hiệu y sinh và dữ liệu bệnh án theo thời gian để hỗ trợ dự báo và chẩn đoán. LSTM có thể được nghiên cứu để phân tích các chuỗi tín hiệu như điện tâm đồ (ECG), nhịp tim hoặc những chỉ số sức khỏe được ghi nhận liên tục. Ví dụ, mô hình có thể học sự thay đổi của tín hiệu ECG qua thời gian để hỗ trợ nhận diện những mẫu nhịp tim bất thường. Tuy nhiên, các kết quả dự đoán cần được kiểm định lâm sàng và đánh giá bởi chuyên gia y tế trước khi sử dụng trong thực tế.
Nhìn chung, LSTM phù hợp với những bài toán mà thứ tự xuất hiện và mối quan hệ theo thời gian giữa các dữ liệu có vai trò quan trọng. Tuy nhiên, việc lựa chọn LSTM hay các kiến trúc khác như GRU và Transformer cần dựa trên đặc điểm dữ liệu, yêu cầu độ chính xác, tốc độ xử lý và tài nguyên tính toán của từng bài toán.
So sánh LSTM và RNN truyền thống
Cả LSTM (Long Short-Term Memory) và RNN (Recurrent Neural Network) đều được thiết kế để xử lý dữ liệu tuần tự. Tuy nhiên, LSTM được cải tiến nhằm khắc phục những hạn chế của RNN truyền thống. Bảng dưới đây sẽ thông tin về sự khác biệt giữa hai kiến trúc này.
| Tiêu chí | LSTM | RNN |
|---|---|---|
| Định nghĩa | Biến thể của RNN, bổ sung Cell State và các cổng điều khiển để lưu giữ thông tin dài hạn. | Mạng nơ-ron hồi quy xử lý dữ liệu tuần tự bằng cách truyền trạng thái ẩn giữa các bước thời gian. |
| Khả năng ghi nhớ | Ghi nhớ hiệu quả cả các phụ thuộc ngắn hạn và dài hạn. | Ghi nhớ tốt các phụ thuộc ngắn hạn, gặp khó khăn với phụ thuộc dài hạn. |
| Chiều xử lý dữ liệu |
LSTM có thể xử lý dữ liệu theo một chiều hoặc được triển khai dưới dạng Bidirectional LSTM (BiLSTM), sử dụng hai luồng LSTM để khai thác ngữ cảnh từ cả trước và sau mỗi vị trí trong chuỗi. | RNN cơ bản xử lý dữ liệu tuần tự theo một chiều thời gian, nhưng có thể mở rộng thành Bidirectional RNN để khai thác thông tin theo cả hai chiều. |
| Vanishing Gradient | Giảm đáng kể ảnh hưởng của hiện tượng vanishing gradient nhờ Cell State và các cổng điều khiển. | Dễ gặp hiện tượng vanishing gradient khi huấn luyện trên chuỗi dài. |
| Hiệu quả với chuỗi dài | Duy trì hiệu quả tốt hơn khi xử lý chuỗi dữ liệu dài. | Hiệu quả giảm khi chuỗi dữ liệu quá dài. |
| Tốc độ huấn luyện | Chậm hơn do nhiều tham số và phép tính hơn. | Nhanh hơn do cấu trúc đơn giản và ít phép tính. |
| Số lượng tham số | Nhiều tham số hơn, yêu cầu nhiều tài nguyên tính toán hơn. | Ít tham số, dễ triển khai. |
| Độ chính xác | Thường đạt độ chính xác cao hơn trong các bài toán có phụ thuộc dài hạn. | Phù hợp với các bài toán có phụ thuộc ngắn hoặc đơn giản. |
| Ứng dụng | Dự báo chuỗi thời gian, nhận dạng giọng nói, dịch máy, phân tích cảm xúc và các bài toán NLP hoặc chuỗi dài. | Phân loại chuỗi, dự báo chuỗi thời gian, NLP với bài toán đơn giản hoặc chuỗi ngắn. |
Tóm lại, nếu bài toán cần xử lý các chuỗi dữ liệu dài và ghi nhớ thông tin trong nhiều bước thời gian, LSTM thường là lựa chọn tốt hơn nhờ khả năng lưu giữ thông tin dài hạn và cho kết quả chính xác hơn. Ngược lại, với những bài toán đơn giản hoặc chuỗi dữ liệu ngắn, RNN vẫn là giải pháp đáng cân nhắc nhờ cấu trúc gọn nhẹ, tốc độ huấn luyện nhanh và chi phí tính toán thấp.
Kết luận
Long Short-Term Memory (LSTM) là một kiến trúc quan trọng trong học sâu, giúp xử lý hiệu quả dữ liệu dạng chuỗi và ghi nhớ thông tin dài hạn. Nếu doanh nghiệp của bạn đang tìm kiếm giải pháp AI để tối ưu vận hành và khai thác dữ liệu, hãy liên hệ FPT.AI qua hotline 1900 638 399 để được đội ngũ chuyên gia tư vấn giải pháp phù hợp với nhu cầu.