vi
 en
 ja


Nhận diện giọng nói đã trở thành công nghệ quan trọng trong thời đại kỹ thuật số hiện nay, hỗ trợ nhiều lĩnh vực từ tự động hóa đến trải nghiệm người dùng. Không chỉ giúp việc nhập liệu nhanh chóng, công nghệ này còn mở ra nhiều ứng dụng trong đời sống hằng ngày. Vậy, nhận diện giọng nói là gì và nó mang lại lợi ích gì cho chúng ta? Hãy cùng FPT.AI khám phá cách công nghệ này hoạt động và những ứng dụng tiêu biểu trong thực tiễn.
Nhận diện giọng nói là gì?
Nhận diện giọng nói (Speech Recognition), hay nhận dạng tiếng nói tự động (Automatic Speech Recognition – ASR), là công nghệ sử dụng trí tuệ nhân tạo (AI) và các mô hình xử lý âm thanh để nhận biết, phân tích và chuyển đổi lời nói của con người thành văn bản.
Hiện nay, nhận diện giọng nói được ứng dụng rộng rãi trong trợ lý ảo, tổng đài chăm sóc khách hàng, thiết bị nhà thông minh và các nền tảng chuyển đổi giọng nói thành văn bản. Khi kết hợp với AI và công nghệ xử lý ngôn ngữ tự nhiên (NLP), hệ thống nhận diện giọng nói không chỉ chuyển lời nói thành văn bản mà còn có thể hỗ trợ phân tích nội dung, xác định ý định và nâng cao hiệu quả tương tác giữa người dùng với thiết bị.
>>> Tìm hiểu thêm: Interactive Voice Response là gì?
Phân biệt Speech Recognition và Voice Recognition
Phân biệt nhận dạng giọng nói với công nghệ nhận dạng người nói:
| Tiêu chí | Nhận dạng giọng nói (Voice Recognition) |
Nhận diện giọng nói (Speech Recognition) |
| Mục đích | Xác định và xác thực người nói |
Nhận biết và chuyển đổi lời nói thành văn bản |
| Phương thức hoạt động | Phân tích các đặc điểm giọng nói như cao độ, tần số, giọng nói để khớp với dấu giọng đã biết | Sử dụng phần mềm nhận diện giọng nói để chuyển ngôn ngữ nói thành văn bản, chú trọng vào việc hiểu nội dung |
| Trường hợp sử dụng | Hệ thống bảo mật, trải nghiệm người dùng cá nhân hóa, xác thực sinh trắc học | Trợ lý ảo, phần mềm đọc chính tả, dịch vụ phiên âm, hệ thống điều khiển |
| Tập trung | Ai là người đang nói | Những gì đang được nói |
| Ứng dụng thực tiễn |
|
|
Ví dụ:
- Nhận diện giọng nói: Khi bạn sử dụng một phần mềm nhận diện giọng nói để ghi chú, công nghệ này sẽ chuyển đổi lời nói của bạn thành văn bản, giúp bạn dễ dàng lưu trữ thông tin.
- Nhận dạng giọng nói: Trong một ứng dụng ngân hàng, khi bạn nói câu mật khẩu, hệ thống sẽ nhận dạng giọng nói của bạn để xác thực danh tính trước khi cho phép truy cập vào tài khoản.
Công nghệ nhận diện giọng nói hoạt động như thế nào?
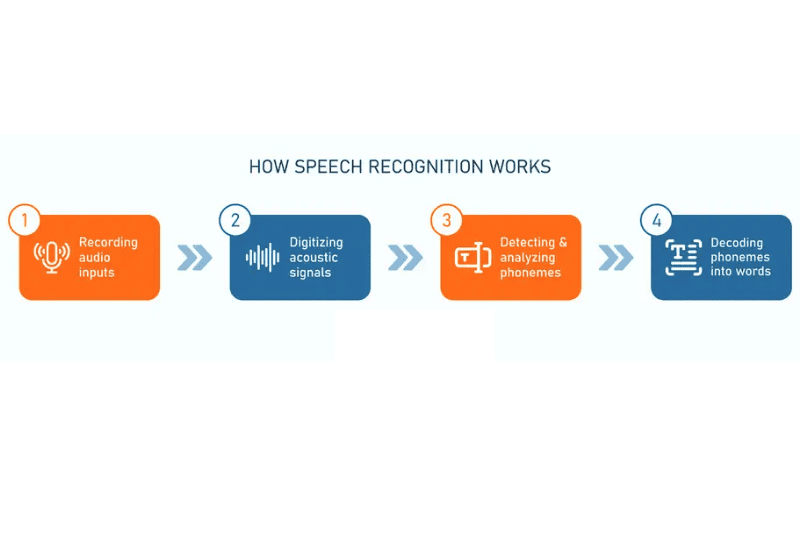
Công nghệ nhận diện giọng nói tự động (ASR – Automatic Speech Recognition) đã trở thành một phần quan trọng trong cuộc sống hiện đại, cho phép chúng ta tương tác với thiết bị thông qua giọng nói. Cách thức hoạt động của hệ thống này gồm bốn bước chính:
- Ghi âm đầu vào âm thanh: Quá trình nhận diện giọng nói bắt đầu khi thiết bị ghi âm thu âm thanh đầu vào từ môi trường xung quanh. Khi một người phát âm, sóng âm được tạo ra sẽ được ghi lại qua micrô. Âm thanh này sẽ bao gồm nhiều yếu tố như độ lớn, tần số và âm điệu, tạo thành một dạng sóng âm để tiếp tục xử lý.
- Số hóa tín hiệu âm thanh: Sau khi thu âm, bước tiếp theo là chuyển đổi tín hiệu âm thanh thành dạng số. Quá trình này sử dụng các kỹ thuật phân tích để biến âm thanh thành quang phổ – một biểu đồ trực quan thể hiện cường độ của các tần số trong suốt thời gian. Quang phổ này cho phép hệ thống nhận diện giọng nói phân tích các đặc điểm âm thanh cần thiết để xác định ngữ âm.
- Phân tích các âm vị: Trong bước này, hệ thống sẽ xác định và phân tích các âm vị, là những đơn vị âm thanh cơ bản tạo thành từ ngữ. Ví dụ, từ “cat” được cấu thành từ ba âm vị: /k/, /æ/, và /t/. Hệ thống sẽ chia quang phổ thành các phần nhỏ hơn để phát hiện và phân loại các âm vị này dựa trên các đặc điểm âm thanh như tần số, thời gian và cường độ.
- Chuyển đổi âm vị thành văn bản: Cuối cùng, hệ thống sử dụng các thuật toán xử lý ngôn ngữ tự nhiên (NLP) để chuyển đổi chuỗi âm vị thành các từ và câu có nghĩa. Quá trình này không chỉ đơn thuần là ghép các âm vị lại với nhau mà còn liên quan đến việc hiểu ngữ cảnh và ý nghĩa của các từ để đảm bảo rằng văn bản được tạo ra phản ánh chính xác những gì đã được nói.
Các tính năng nổi bật của công nghệ nhận diện giọng nói
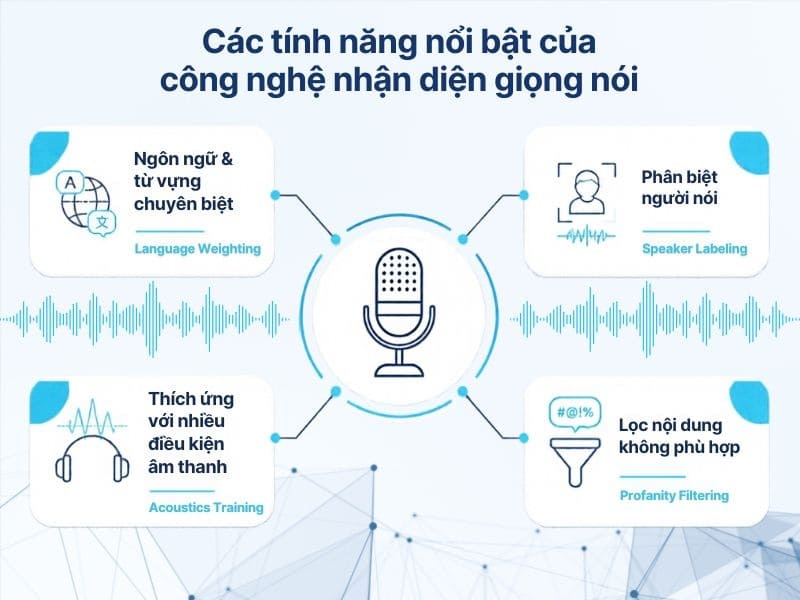
Để nâng cao khả năng nhận diện và xử lý hội thoại, các hệ thống nhận diện giọng nói hiện nay được tích hợp nhiều tính năng hỗ trợ phân tích ngôn ngữ, nhận biết người nói và tối ưu chất lượng đầu ra, bao gồm:
- Tùy chỉnh từ vựng chuyên ngành (Speech Adaptation): Cho phép hệ thống ưu tiên nhận dạng tên riêng, thuật ngữ hoặc cụm từ thường xuất hiện trong từng lĩnh vực, góp phần cải thiện độ chính xác khi chuyển giọng nói thành văn bản.
- Phân biệt người nói (Speaker Diarization): Hệ thống phân chia và gắn nhãn các đoạn hội thoại theo từng người nói (Speaker 1, Speaker 2…), giúp theo dõi nội dung trao đổi trong cuộc họp, cuộc gọi hoặc bản ghi âm nhiều người.
- Xử lý âm thanh trong nhiều điều kiện: Hệ thống có thể áp dụng các kỹ thuật tiền xử lý âm thanh, giảm nhiễu và mô hình nhận dạng được huấn luyện trên dữ liệu đa dạng để cải thiện kết quả khi có tiếng ồn hoặc khác biệt về giọng nói.
- Lọc từ ngữ nhạy cảm (Profanity Filtering): Một số nền tảng hỗ trợ phát hiện, che hoặc thay thế các từ ngữ không phù hợp trong văn bản phiên âm theo cấu hình sử dụng.
Các mô hình và công nghệ hỗ trợ nhận diện giọng nói
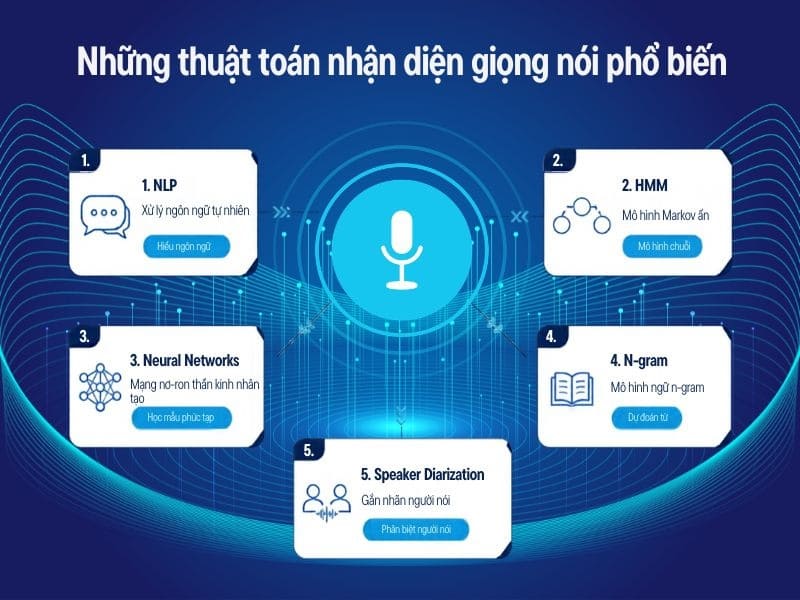
Hệ thống nhận dạng giọng nói (Speech Recognition) sử dụng nhiều mô hình và công nghệ để xử lý âm thanh, nhận diện lời nói và chuyển đổi thành văn bản. Một số công nghệ nổi bật gồm:
- Xử lý ngôn ngữ tự nhiên (NLP): Hỗ trợ phân tích ngữ cảnh, xử lý dấu câu và hiệu chỉnh văn bản nhằm cải thiện kết quả nhận dạng.
- Mô hình Markov ẩn (HMM): Mô hình xác suất được sử dụng phổ biến trong các hệ thống nhận dạng giọng nói truyền thống để mô hình hóa chuỗi trạng thái ngữ âm. Hiện nay, nhiều hệ thống ASR đã chuyển sang sử dụng các kiến trúc học sâu hiện đại.
- Mạng nơ-ron nhân tạo (Neural Networks): Sử dụng các kiến trúc học sâu như RNN, CNN và Transformer để học đặc trưng âm thanh và nhận dạng lời nói.
- Mô hình N-gram: Mô hình ngôn ngữ thống kê giúp dự đoán từ dựa trên các từ đứng trước, hỗ trợ lựa chọn kết quả nhận dạng phù hợp trong hệ thống ASR truyền thống. Hiện nay, nhiều hệ thống sử dụng mô hình ngôn ngữ dựa trên mạng nơ-ron thay thế hoặc kết hợp với N-gram.
Ứng dụng công nghệ nhận diện giọng nói trong thực tế
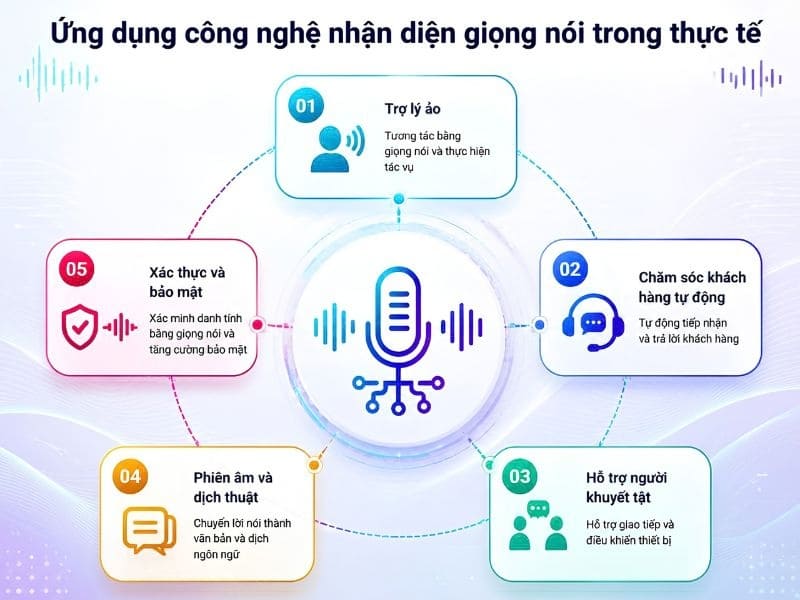
Công nghệ nhận diện giọng nói đang được ứng dụng ngày càng rộng rãi trong nhiều lĩnh vực, từ đời sống hàng ngày đến hoạt động vận hành của doanh nghiệp, nhờ khả năng chuyển đổi lời nói thành dữ liệu có thể xử lý tự động:
- Trợ lý ảo: Hỗ trợ người dùng thực hiện các tác vụ bằng giọng nói như tìm kiếm thông tin, đặt lịch, gửi tin nhắn hoặc điều khiển thiết bị thông minh.
- Chăm sóc khách hàng tự động: Tích hợp vào tổng đài AI để tiếp nhận, nhận diện nhu cầu và hỗ trợ xử lý yêu cầu của khách hàng nhanh chóng hơn.
- Hỗ trợ người khuyết tật: Giúp người dùng điều khiển thiết bị, nhập liệu hoặc truy cập thông tin bằng giọng nói thay cho các phương thức tương tác truyền thống.
- Phiên âm và dịch thuật: Tự động chuyển lời nói trong cuộc họp, hội thảo hoặc cuộc gọi thành văn bản. Khi kết hợp với công nghệ dịch máy, hệ thống còn có thể hỗ trợ dịch nội dung sang ngôn ngữ khác.
- Kết hợp xác thực bằng giọng nói: Khi tích hợp với công nghệ sinh trắc học giọng nói, hệ thống có thể hỗ trợ xác minh danh tính người dùng trong các dịch vụ tài chính, ngân hàng và nền tảng số.
- Hệ thống dẫn đường: Hệ thống dẫn đường như Google Maps cho phép người lái xe sử dụng lệnh thoại để tìm đường mà không cần phải nhìn vào màn hình. Người lái xe có thể tập trung hơn vào việc lái xe, từ đó tăng cường sự an toàn trên đường.
- Giáo dục: Trong lĩnh vực giáo dục, ứng dụng như Duolingo giúp người học cải thiện kỹ năng ngôn ngữ thông qua việc luyện phát âm. Hệ thống nhận diện giọng nói sẽ đánh giá độ chính xác của cách phát âm so với mẫu chuẩn, từ đó giúp người học cải thiện khả năng nói của mình.
Với khả năng tự động hóa và nâng cao trải nghiệm tương tác, nhận diện giọng nói đang trở thành một trong những công nghệ quan trọng trong quá trình chuyển đổi số của doanh nghiệp và tổ chức.
Gợi ý 4 phần mềm áp dụng công nghệ nhận diện giọng nói
Dưới đây là một số công cụ được sử dụng phổ biến nhờ khả năng nhận diện giọng nói chính xác và dễ tích hợp vào công việc hằng ngày.
FPT AI Enhance
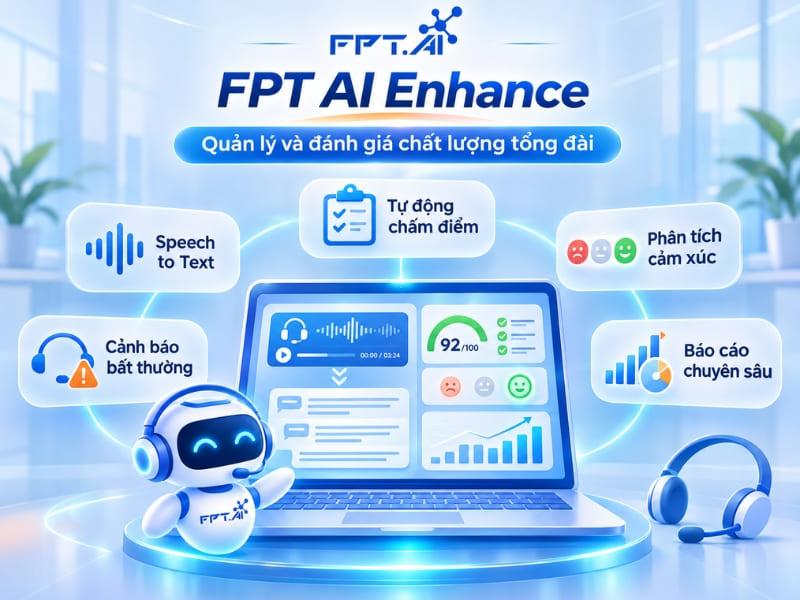
FPT AI Enhance là giải pháp quản lý và đánh giá chất lượng tổng đài của FPT.AI, ứng dụng công nghệ nhận diện giọng nói (Speech to Text) để chuyển đổi nội dung cuộc gọi thành văn bản, hỗ trợ phân tích và nâng cao hiệu quả chăm sóc khách hàng.
Các tính năng nổi bật gồm:
- Nhận diện giọng nói (ASR): Chuyển đổi âm thanh cuộc gọi thành văn bản để phục vụ phân tích.
- Tự động chấm điểm: Đánh giá chất lượng cuộc gọi dựa trên các tiêu chí thiết lập.
- Phân tích cảm xúc: Nhận diện diễn biến cảm xúc của khách hàng trong cuộc hội thoại.
- Cảnh báo bất thường: Phát hiện các cuộc gọi cần kiểm tra và đánh giá lại.
- Báo cáo chuyên sâu: Cung cấp dữ liệu phân tích giúp doanh nghiệp cải thiện chất lượng tổng đài.
Google Cloud Speech-to-Text
Google Cloud Speech-to-Text là dịch vụ nhận dạng giọng nói của Google Cloud, hỗ trợ chuyển đổi âm thanh thành văn bản thông qua các mô hình AI. Nền tảng cung cấp khả năng phiên âm tệp âm thanh, xử lý dữ liệu giọng nói theo luồng và tích hợp vào ứng dụng thông qua API.
Google Docs Voice Typing
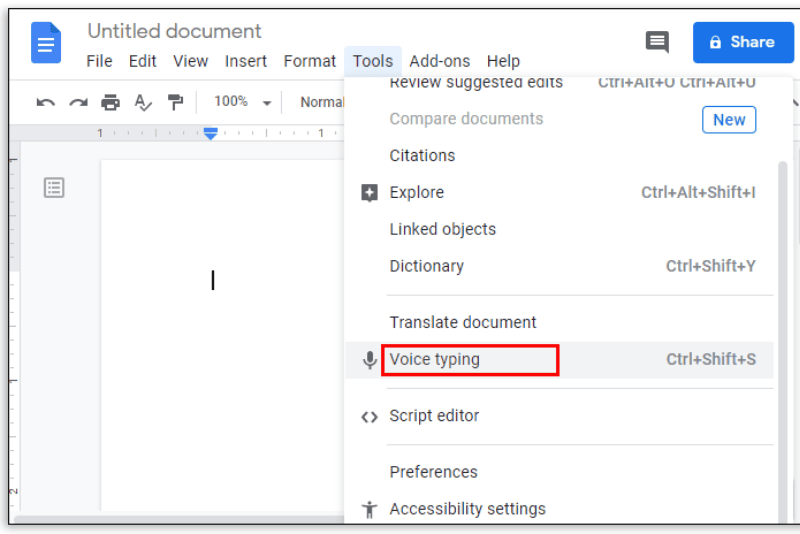
Google Docs Voice Typing là tính năng nhập liệu bằng giọng nói được tích hợp trực tiếp trong Google Docs. Công cụ cho phép người dùng chuyển lời nói thành văn bản theo thời gian thực, hỗ trợ nhiều ngôn ngữ và phù hợp với các nhu cầu soạn thảo nội dung hằng ngày.
Với giao diện đơn giản và dễ sử dụng, Google Docs Voice Typing giúp giảm thời gian nhập liệu thủ công, đặc biệt hữu ích đối với người thường xuyên ghi chú, biên soạn tài liệu hoặc làm việc với khối lượng văn bản lớn.
Azure AI Speech
Azure AI Speech là dịch vụ xử lý giọng nói của Microsoft, cung cấp khả năng chuyển lời nói thành văn bản, hỗ trợ phiên âm âm thanh và tích hợp chức năng nhận dạng giọng nói vào ứng dụng. Nền tảng phù hợp với các doanh nghiệp và nhà phát triển muốn xây dựng giải pháp xử lý âm thanh tự động.
>>> Xem thêm: Tổng hợp 5 công cụ chuyển ghi âm thành văn bản
Xu hướng phát triển và mở rộng ứng dụng của ASR
Công nghệ nhận dạng giọng nói (ASR) đang được cải tiến về độ chính xác, khả năng xử lý ngôn ngữ và tích hợp với các hệ thống AI. Một số xu hướng đáng chú ý gồm:
- Nhận diện đa ngôn ngữ: Cải thiện khả năng xử lý phương ngữ, giọng địa phương và cá nhân hóa theo người dùng.
- Tích hợp nhà thông minh: Kết hợp với IoT để điều khiển thiết bị bằng giọng nói.
- Kết hợp AI tạo sinh: Ứng dụng LLM để hỗ trợ hiểu ngữ cảnh và tương tác tự nhiên hơn.
- Mở rộng ứng dụng chuyên ngành: Hỗ trợ ghi chép y tế, chuyển lời giảng thành văn bản và chăm sóc khách hàng.
- Tăng cường bảo mật: Bảo vệ dữ liệu âm thanh và kết hợp sinh trắc học giọng nói để hỗ trợ xác thực danh tính.
Câu hỏi thường gặp về nhận diện giọng nói
Công nghệ nhận diện giọng nói có độ chính xác cao không?
Độ chính xác tùy ngôn ngữ, nhiễu, giọng địa phương và mô hình; có thể đánh giá bằng WER trên bộ dữ liệu phù hợp. Hệ thống nhận diện giọng nói ứng dụng AI có độ chính xác cao trong điều kiện âm thanh rõ ràng, nhưng vẫn chịu ảnh hưởng bởi tiếng ồn, tốc độ nói và giọng địa phương.
Nhận diện giọng nói có đảm bảo an toàn dữ liệu không?
Mức độ an toàn dữ liệu phụ thuộc vào công nghệ bảo mật, chính sách xử lý thông tin và cách triển khai hệ thống. Doanh nghiệp nên ưu tiên giải pháp có cơ chế mã hóa, kiểm soát quyền truy cập, chính sách lưu trữ rõ ràng và đáp ứng các yêu cầu bảo vệ dữ liệu liên quan.
>>> Đọc thêm: Giọng nói AI là gì?
Lời kết
Công nghệ nhận diện giọng nói giúp doanh nghiệp tự động hóa quy trình, khai thác dữ liệu và nâng cao trải nghiệm khách hàng. Với các giải pháp AI xử lý tiếng nói, FPT.AI hỗ trợ chuyển giọng nói thành văn bản, xây dựng hệ thống tương tác thông minh và tự động hóa chăm sóc khách hàng. Nhờ khả năng tích hợp linh hoạt, doanh nghiệp có thể tối ưu vận hành, nâng cao hiệu suất và đẩy nhanh quá trình chuyển đổi số.