vi
 en
 ja


Bộ dữ liệu Nemotron-Personas-Vietnam đang hỗ trợ FPT phát triển thế hệ trợ lý thoại tự động (voicebot) dành cho telesales, có khả năng điều chỉnh giọng điệu và nội dung tư vấn phù hợp với khách hàng ngay từ cuộc gọi đầu tiên. Được xây dựng dựa trên phân bố thực tế về nhân khẩu học, khu vực sinh sống và đặc điểm tính cách của người Việt Nam, bộ dữ liệu tổng hợp giúp voicebot mô phỏng những chân dung khách hàng một cách chân thực để lựa chọn cách tiếp cận phù hợp, nhằm cải thiện tỷ lệ chuyển đổi trong bán hàng qua điện thoại.
Kịch bản rập khuôn không hiệu quả với mọi khách hàng
Hầu hết voicebot telesales hiện nay sử dụng cùng một kịch bản cho mọi khách hàng: Lời chào mở đầu, nội dung chào bán sản phẩm và nhịp độ trò chuyện, bất kể người nghe máy là ai. Cách tiếp cận này khiến khách hàng kết thúc cuộc gọi sớm, tỷ lệ chuyển đổi thấp, tạo ra trải nghiệm kém vì họ cảm giác đang nghe một bài giới thiệu sản phẩm sẵn, thay vì được tư vấn đúng nhu cầu.
Một khách hàng đã nghỉ hưu ở Hà Nội và một kỹ sư trẻ tại Thành phố Hồ Chí Minh đòi hỏi cách diễn đạt, nhịp độ trò chuyện cũng như tư vấn ưu đãi khác nhau. Đây là những gì kịch bản cuộc gọi cố định truyền thống chưa đáp ứng được, trong khi voicebot cá nhân hóa đang mở ra tiềm năng mới, nơi mọi khách hàng đều được lắng nghe.
Thách thức là làm thế nào để cá nhân hóa cuộc gọi khi dữ liệu khách hàng thật thường nhạy cảm, chịu sự quản lý chặt chẽ và khó tiếp cận cho mục đích huấn luyện AI. Trong lĩnh vực ngân hàng và bảo hiểm, việc tiếp cận dữ liệu khách hàng thật để phát triển AI có thể mất nhiều tháng để phê duyệt; ngay cả khi được cấp quyền, một phần dữ liệu thường bị ẩn để bảo vệ quyền riêng tư, gây khó khăn cho quá trình huấn luyện.
Xây dựng chân dung khách hàng có khả năng thích ứng
Dựa trên chân dung khách hàng (persona), voicebot có thể điều chỉnh giọng điệu, nhịp độ và nội dung giao tiếp ngay từ cuộc gọi đầu tiên, sau đó tiếp tục cải thiện độ chính xác qua từng tương tác.
Bộ dữ liệu Nemotron-Personas-Vietnam cung cấp 1.000.000 persona hoàn toàn tổng hợp, được xây dựng dựa trên số liệu thống kê chính thức của Việt Nam từ Tổng cục Thống kê (GSO), bao gồm Điều tra Dân số và Nhà ở năm 2024 và Khảo sát Mức sống Dân cư Việt Nam (VHLSS) năm 2024, cùng các nguồn dữ liệu từ FPT Smart Cloud và Viện Nghiên cứu Quantum AI & Cyber Security, Tập đoàn FPT. Vì các persona là dữ liệu tổng hợp, không phải những hồ sơ cá nhân có thật, giúp giảm rủi ro về quyền riêng tư và cho phép huấn luyện, đánh giá voicebot mà không cần sử dụng dữ liệu khách hàng thật.
Để xem đầy đủ phương pháp luận, cấu trúc (schema) và phạm vi bao phủ của bộ dữ liệu, tham khảo bài viết kỹ thuật chuyên sâu về Nemotron-Personas-Vietnam của chúng tôi.
Cách bộ dữ liệu được sử dụng
Quy trình vận hành theo một vòng lặp liên tục gồm 6 bước: Khởi tạo chân dung khách hàng (persona) → Xây dựng chiến lược giao tiếp → Thực hiện cuộc gọi → Cập nhật chân dung khách hàng → Sử dụng thông tin mới cho cuộc gọi tiếp theo.
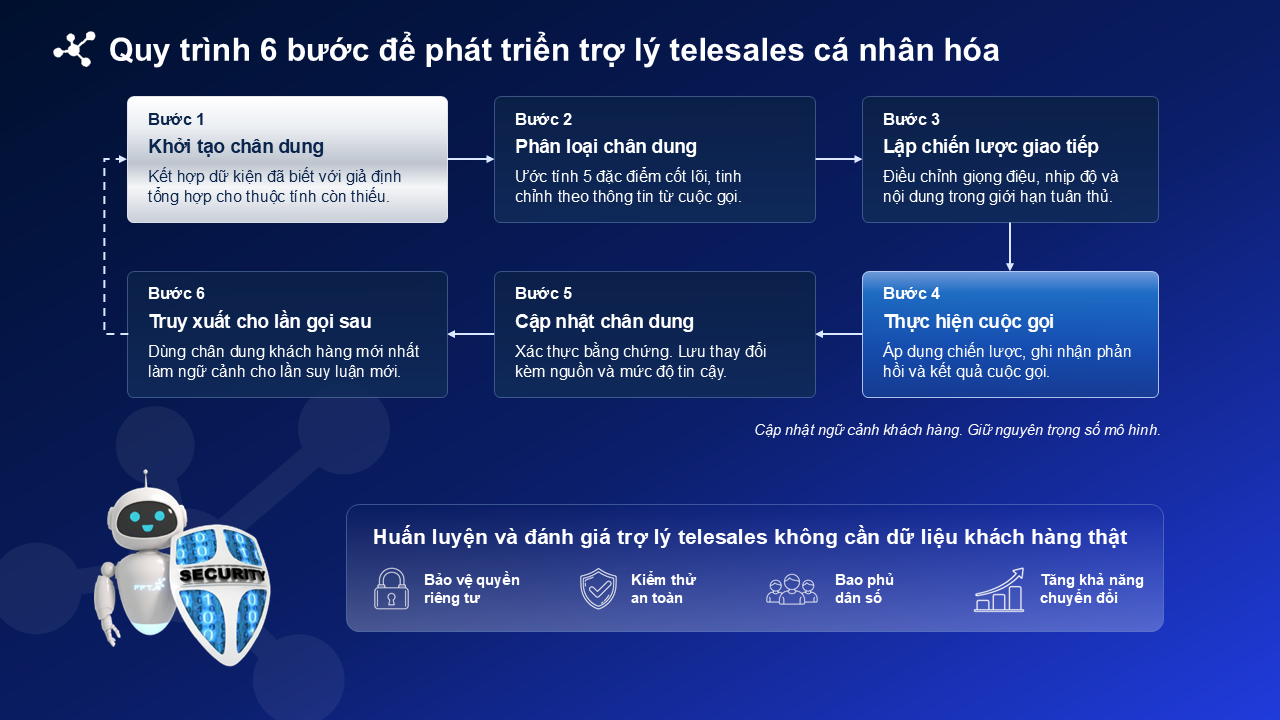
Bước 1. Khởi tạo chân dung khách hàng
Khi bắt đầu tiếp cận một khách hàng mới, hệ thống xây dựng persona ban đầu bằng cách kết hợp thông tin đã biết về khách hàng với những giả định tổng hợp lý đối với các thuộc tính còn thiếu.
Thuộc tính khách hàng đã biết: Các dữ liệu nhân khẩu học và thông tin khách hàng hiện có như độ tuổi, khu vực, nghề nghiệp, thu nhập, trình độ học vấn, dữ liệu CRM, lịch sử giao dịch, dữ liệu cuộc gọi và hành vi có thể được ghi nhận, tạo thành nền tảng dữ kiện cho persona.
Nemotron-Personas-Vietnam: Bộ dữ liệu được sử dụng để bổ sung các khoảng trống trong hồ sơ ban đầu bằng cách truy xuất hoặc lấy mẫu những persona phù hợp với các thuộc tính đã biết của khách hàng. Những đặc điểm còn thiếu, chẳng hạn bối cảnh lối sống, sở thích, tính cách hoặc khuynh hướng hành vi, được xem là giả định tổng hợp chứ không phải thông tin thực tế về khách hàng.
Bổ sung và cập nhật theo dữ liệu thực tế: Khi có thêm thông tin cụ thể về khách hàng từ các cuộc hội thoại, CRM, giao dịch, dữ liệu cuộc gọi hoặc tín hiệu hành vi, hệ thống sẽ cập nhật, thay thế hoặc loại bỏ những giả định tổng hợp ban đầu.
Nhờ đó, hệ thống có một chân dung khách hàng ban đầu đủ thông tin để mô phỏng và cá nhân hóa,, đồng thời phân biệt rõ dữ kiện đã được khi nhận, thông tin tham chiếu từ thông kê dân số và giả định tổng hợp.
Bước 2. Phân loại chân dung khách hàng
Chân dung khách hàng được xác định bởi năm đặc điểm cốt , tiếp tục được tinh chỉnh theo thời gian dựa trên lịch sử cuộc gọi:
| Đặc điểm | Nội dung phản ánh |
| Mức độ kiên nhẫn (patience) | Khách hàng duy trì tương tác trong bao lâu trước khi mất hứng thú |
| Mức độ am hiểu tài chính (financial_familiarity) | Mức độ quen thuộc và thoải mái của khách hàng với các thuật ngữ, khái niệm tài chính |
| Nhu cầu vốn và tiết kiệm (capital_need) | Khách hàng có nhu cầu vay vốn hoặc sản phẩm tiết kiệm hay không |
| Mức độ nhạy cảm về giá (price_sensitivity) | Mức độ phản ứng của khách hàng trước giá và các loại phí |
| Mức độ tạo dựng niềm tin (trust_sensitivity) | Mức độ khách hàng cần được trấn an và cung cấp thông tin chứng minh độ uy , tin cậy |
Các đặc điểm này không cố định. Ban đầu, chúng là những ước tính từ persona khởi tạo và được cập nhật dựa trên thông tin ghi nhận sau mỗi cuộc gọi.
Bước 3. Xây dựng chiến lược giao tiếp theo chân dung khách hàng
Dựa trên persona, voicebot xây dựng chiến lược giao tiếp gồm:
- Lựa chọn kịch bản phù hợp: Chọn lời mở đầu, nội dung chào bán và phần kết phù hợp với khách hàng.
- Tạo ngữ cảnh hội thoại: Xây dựng các thông tin phục vụ hội thoại gồm chân dung khách hàng (persona), mô tả (description), luồng hội thoại (conversation_flow) và tình huống (scenario).
- Thiết lập giới hạn tuân thủ: Xác định quy tắc tuân thủ và các nhánh hội thoại cốt lõi mà voicebot không được vượt qua, bất kể persona nào. Các rào chắn này giúp bảo đảm mọi cuộc gọi luôn nằm trong giới hạn pháp lý và nguyên tắc thương hiệu.
Mục tiêu không phải là gán nhãn khách hàng theo khuôn mẫu, mà là bắt đầu từ một hồ sơ có cơ sở thống kê, sát thực tế, sau đó tiếp tục điều chỉnh dựa trên thông tin thực tế.
| Đặc điểm persona | Cách voicebot điều chỉnh giao tiếp |
| patience cao, financial_familiarity thấp | Nói nhịp độ chậm hơn, giải thích bằng ngôn ngữ dễ hiểu, tập trung vào tính bảo mật và ổn định |
| patience thấp, financial_familiarity cao | Giao tiếp nhanh hơn, trực tiếp, nhấn mạnh tính hiệu quả và các tính năng cao cấp |
| price_sensitivity cao, khu vực nông thôn | Sử dụng tham chiếu địa phương, cách diễn đạt thực tế, ngôn ngữ gắn với mùa vụ và dòng tiền |
| trust_sensitivity cao, hộ gia đình 4 người | Cách diễn đạt hướng đến gia đình, thông tin tạo dựng uy tín, sản phẩm giáo dục và tiết kiệm |
Bước 4. Thực hiện cuộc gọi
Voicebot thực hiện cuộc gọi theo chiến lược đã chọn và ghi nhận phản hồi của khách hàng: mức độ tương tác, ý kiến phản đối, câu hỏi, giọng điệu và kết quả cuộc gọi, chẳng hạn đạt mục tiêu chuyển đổi, hẹn liên hệ lại hoặc kết thúc cuộc gọi.
Bước 5. Cập nhật chân dung khách hàng sau cuộc gọi
Sau mỗi cuộc gọi, hệ thống cập nhật customer persona được lưu trữ:
- Lưu bản ghi âm và nội dung cuộc gọi được chuyển thành văn bản (transcript).
- Sử dụng kĩ thuật mã hóa E5 và phân tích hội thoại để trích xuất các tín hiệu như ý kiến phản đối, mức độ tương tác, sắc thái cảm xúc (sentiment), sở thích và kết quả cuộc gọi.
- Kiểm tra bằng chứng xác định từng tín hiệu có đủ tin cậy để điều chỉnh persona hay không.
- Các thuộc tính đã xác thực được ghi trở lại cơ sở dữ liệu persona, kèm nguồn thông tin và mức độ tin cậy; nếu chưa đủ bằng chứng, hệ thống giữu nguyên thông tin hiện có.
Theo thời gian, các hành vi thực tế được ghi nhận từ khách hàng sẽ dần điều chỉnh hoặc thay thế các giả định tổng hợp ban đầu.
Hệ thống không cập nhật trọng số mô hình (model weights) sau mỗi cuộc gọi. Phần được cập nhật là thông tin về khách hàng lưu trong cơ sở dữ liệu,,
Bước 6. Sử dụng persona đã cập nhật cho cuộc gọi tiếp theo
Trong lần tương tác tiếp theo, hệ thống truy xuất chân dung khách hàng mới nhất từ cơ sở dữ liệu và sử dụng làm ngữ cảnh để mô hình AI tạo phản hồi mới..
Bản thân mô hình AI không thay đổi. Yếu tố được cải thiện là thông tin ngữ cảnh riêng của từng khách hàng: Khi có thêm bằng chứng thực tế, agent sẽ ít phụ thuộc hơn vào các giả định tổng hợp ban đầu và dựa nhiều hơn vào sở thích, hành vi đã được ghi nhận từ khách hàng.
Truy xuất persona đã cập nhật → Đưa vào làm ngữ cảnh → Mô hình thực hiện suy luận với trọng số không đổi.
Nemotron-Personas-Vietnam hỗ trợ quy trình này như thế nào?
Lợi thế của Nemotron-Personas-Vietnam là hỗ trợ phát triển, huấn luyện và đánh giá voicebot trên những chân dung khách hàng mô phỏng sát thực tế mà không cần sử dụng hồ sơ khách hàng thật cho các hoạt động này. Trong lĩnh vực ngân hàng và bảo hiểm, dữ liệu khách hàng thực tế thường nhạy cảm, được quản lý chặt chẽ và mất nhiều thời gian để tiếp cận. Với 1 triệu chân dung tổng hợp dựa trên số liệu thống kê Việt Nam, bộ dữ liệu cung cấp nguồn tham chiếu đa dạng về nhóm thu nhập, khu vực sinh sống, nghề nghiệp và trình độ học vấn, đồng thời góp phần giảm rủi ro liên quan đến quyền riêng tư.Nhờ đó, đội ngũ phát triển có thể kiểm thử và đánh giá voicebot bằng các hồ sơ tổng hợp, giảm sự phụ thuộc vào dữ liệu khách hàng thật. Tuy nhiên, việc kiểm thử vẫn cần xem xét các rủi ro về quyền riêng tư, thiên lệch giữa các nhóm dân cư và tính phù hợp của mục đích sử dụng, đặc biệt khi hệ thống kết nối với dữ liệu khách hàng thực tế.Về lâu dài, voicebot được thiết kế nhằm cải thiện tỷ lệ chuyển đổi trong hoạt động telesales thông qua cách giao tiếp phù hợp hơn với từng khách hàng. Cá nhân hóa ngay từ cuộc gọi đầu tiên hướng tới giảm tình trạng kết thúc cuộc gọi sớm; việc cập nhật chân dung sau mỗi tương tác giúp những lần liên hệ tiếp theo phù hợp hơn. Khi thông tin thực tế ngày càng đầy đủ, hệ thống có cơ sở để xây dựng chân dung khách hàng chính xác hơn và nâng cao hiệu quả chuyển đổi.
——
Truy cập bộ dữ liệu miễn phí trên Hugging Face: https://huggingface.co/datasets/nvidia/Nemotron-Personas-Vietnam
Nhà phát triển có thể tải bộ dữ liệu bằng đoạn mã sau.
from datasets import load_dataset
# Persona tiếng Việt — Vietnamese personas
nemotron_personas = load_dataset(“nvidia/Nemotron-Personas-Vietnam”, split=”train”)