vi
 en
 ja


Convolutional neural network (CNN) là một loại mạng nơ-ron nhân tạo có khả năng xử lý và phân tích dữ liệu hình ảnh, âm thanh và tín hiệu trong không gian 3 chiều cực kỳ hiệu quả. Trong bài viết này, FPT.AI sẽ trình bày chi tiết về cơ chế hoạt động của CNNs, từ các tầng cơ bản như Convolutional Layer, Pooling Layer, đến các Fully-connected Layers. Bên cạnh đó, bài viết cũng sẽ giới thiệu các loại CNNs nổi bật, cùng với những ứng dụng thực tế mà công nghệ này mang lại.
Convolutional Neural Network (CNN) là gì?
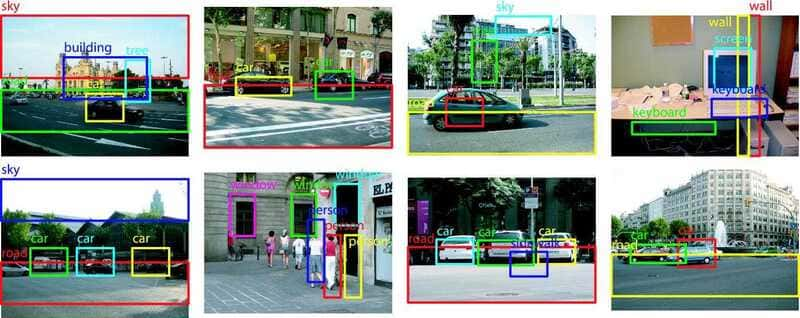
CNN là một kiến trúc mạng nơ-ron đặc biệt phù hợp với dữ liệu có cấu trúc lưới, phổ biến nhất là hình ảnh. CNN được ứng dụng trong phân loại ảnh, phát hiện đối tượng, nhận diện khuôn mặt và phân tích ảnh y tế.
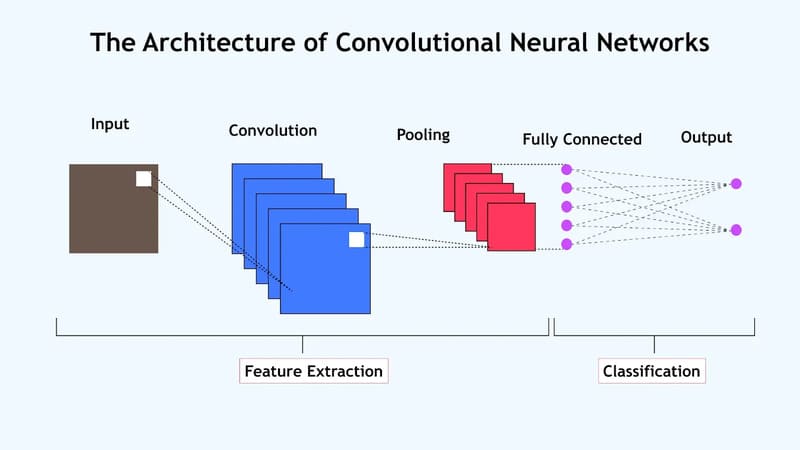
CNN dựa trên các nguyên lý như local receptive field (xử lý từng vùng dữ liệu nhỏ), parameter sharing (chia sẻ trọng số) và hierarchical feature learning (học đặc trưng theo nhiều cấp độ). Nhờ đó, CNN giảm số tham số so với mạng Fully Connected và khai thác hiệu quả cấu trúc không gian của hình ảnh.
>>> Tìm hiểu thêm: Recurrent Neural Network là gì?
Các lớp cơ bản và cơ chế hoạt động của mạng nơ ron tích chập
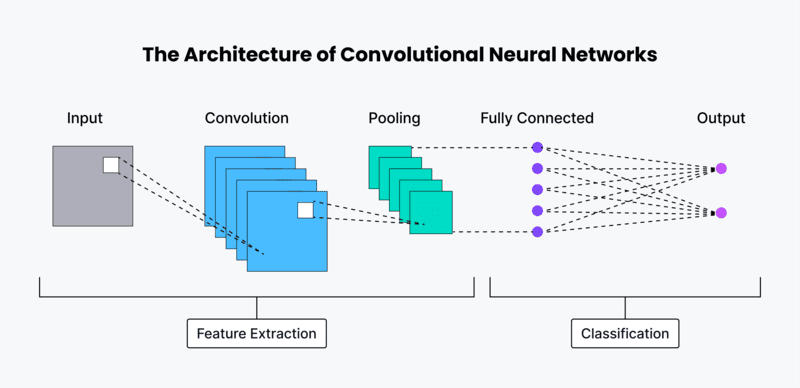
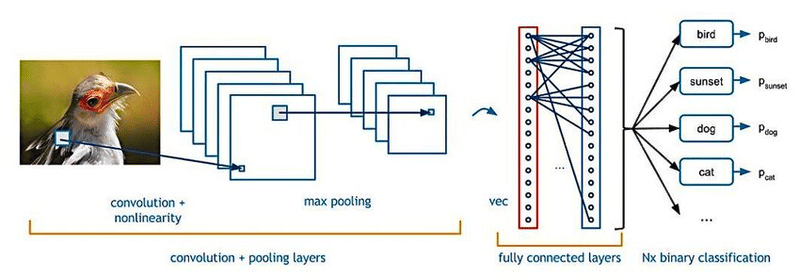
CNN xử lý dữ liệu qua nhiều lớp để từng bước trích xuất đặc trưng và tạo kết quả đầu ra. Mỗi lớp đảm nhiệm một chức năng riêng trong quá trình xử lý hình ảnh.
Convolutional Layer (Tầng tích chập)
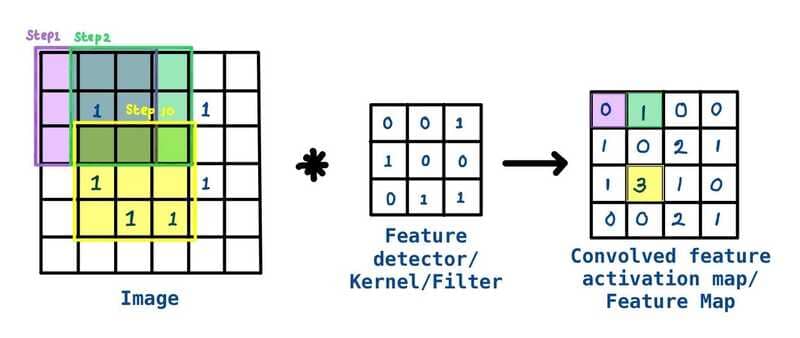
Đây là lớp cốt lõi của CNN, sử dụng các bộ lọc (kernel) quét trên ảnh để tạo feature map và nhận diện các đặc trưng như cạnh, đường nét hoặc kết cấu.
Các tham số chính gồm:
- Filter (Kernel): Bộ lọc dùng để trích xuất đặc trưng.
- Stride: Khoảng dịch chuyển của bộ lọc sau mỗi lần quét.
- Padding: Thêm giá trị quanh biên để kiểm soát kích thước đầu ra.
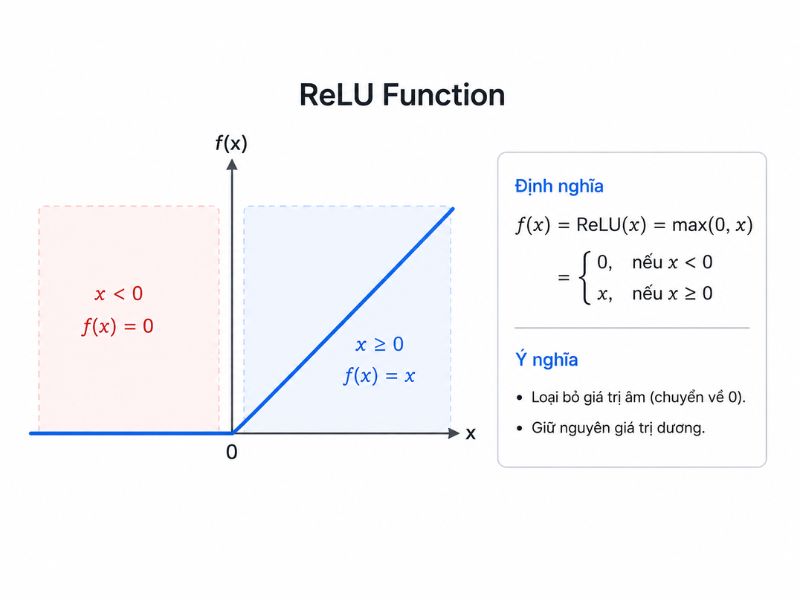
Sau phép tích chập, ReLU thường được sử dụng để bổ sung tính phi tuyến, giúp mạng học các đặc trưng phức tạp hơn.
Ví dụ: Với ảnh xe đạp, các lớp tích chập đầu có thể nhận biết cạnh và đường nét; những lớp sâu hơn kết hợp chúng thành đặc trưng như bánh xe hoặc khung xe.
Additional convolutional layer
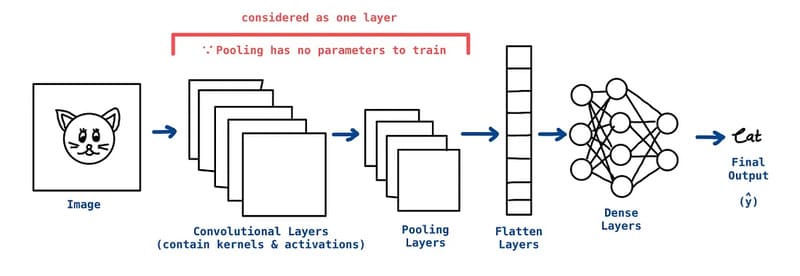
Việc bổ sung nhiều Convolutional Layer giúp CNN học đặc trưng theo từng cấp độ. Các lớp đầu thường nhận biết đặc trưng đơn giản như cạnh hoặc hình dạng, trong khi lớp sâu hơn kết hợp chúng thành các đặc trưng phức tạp để nhận diện đối tượng.
Ví dụ, khi nhận diện xe đạp, CNN có thể học các đặc điểm như bánh xe, khung và tay lái, sau đó kết hợp chúng để xác định hình ảnh có chứa xe đạp.
Pooling Layer (Tầng gộp)
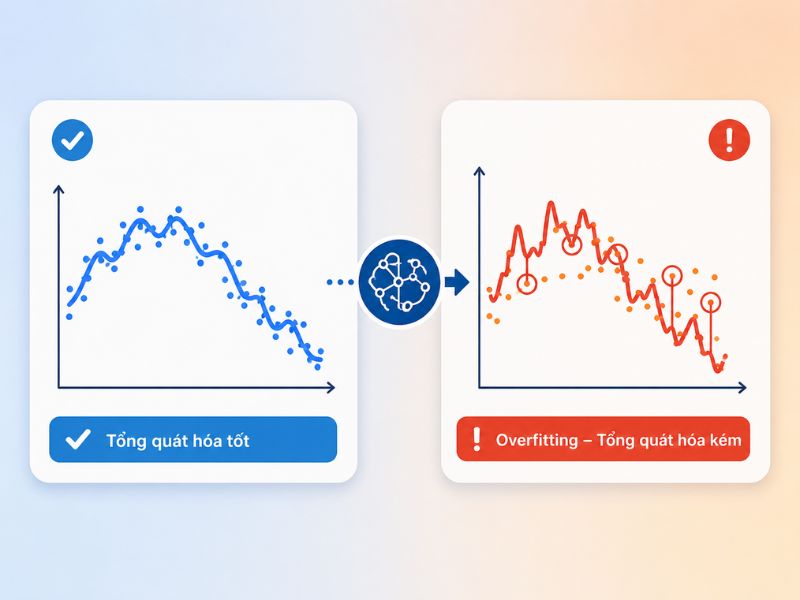
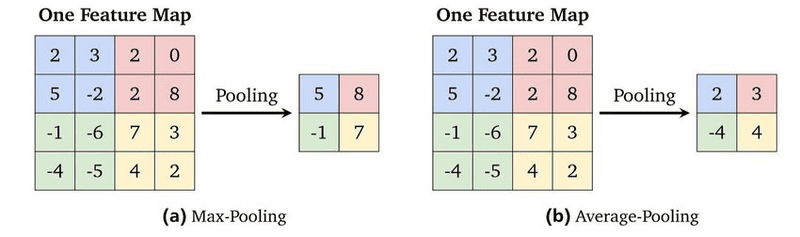
Sau khi Convolutional Layer trích xuất đặc trưng, Pooling Layer sẽ giảm kích thước của feature map nhằm giảm số lượng tham số và chi phí tính toán. Điều này giúp mô hình học nhanh hơn, hạn chế hiện tượng overfitting và tăng khả năng tổng quát hóa khi gặp dữ liệu mới.
Hai phương pháp phổ biến gồm:
- Max Pooling: Giữ lại giá trị lớn nhất trong vùng quét để làm nổi bật các đặc trưng quan trọng.
- Average Pooling: Tính giá trị trung bình trong vùng quét để tổng hợp thông tin.
Mặc dù làm giảm lượng dữ liệu cần xử lý, Pooling Layer vẫn giữ được những đặc trưng nổi bật của đối tượng. Nhờ đó, CNN có thể nhận diện cùng một vật thể ngay cả khi vị trí hoặc kích thước của nó thay đổi trong ảnh.
Ví dụ: Nếu nhiều điểm ảnh cùng biểu diễn bánh xe của xe đạp, Pooling Layer sẽ giữ lại tín hiệu nổi bật nhất thay vì toàn bộ chi tiết dư thừa, giúp mô hình nhận diện đối tượng hiệu quả hơn.
Fully Connected / Output Layer
Sau khi các đặc trưng được trích xuất và rút gọn, Fully Connected Layer sẽ tổng hợp toàn bộ thông tin để đưa ra dự đoán cuối cùng. Dữ liệu từ các feature map được làm phẳng (Flattening) thành vector một chiều trước khi đưa vào các nơ-ron kết nối đầy đủ.
Tại đây, CNN sẽ đánh giá mối liên hệ giữa các đặc trưng đã học được và xác định đối tượng thuộc lớp nào. Tầng đầu ra thường sử dụng các hàm kích hoạt như Softmax hoặc Sigmoid để tính xác suất cho từng nhãn dự đoán.
Ví dụ: Sau khi các tầng trước đã nhận diện được bánh xe, khung xe và tay lái, Fully Connected Layer sẽ kết hợp các đặc trưng này để kết luận hình ảnh thuộc lớp “xe đạp” với xác suất cao nhất.
Additional layers
Ngoài các lớp chính, CNN thường bổ sung thêm một số lớp hỗ trợ để cải thiện khả năng học và độ ổn định của mô hình trong quá trình huấn luyện:
- Activation Layer: Áp dụng các hàm kích hoạt như ReLU, Sigmoid hoặc Tanh để tăng khả năng tính phi tuyến và khả năng học của mô hình.
- Dropout Layer: Loại bỏ ngẫu nhiên một số nơ-ron trong quá trình huấn luyện nhằm giảm overfitting.
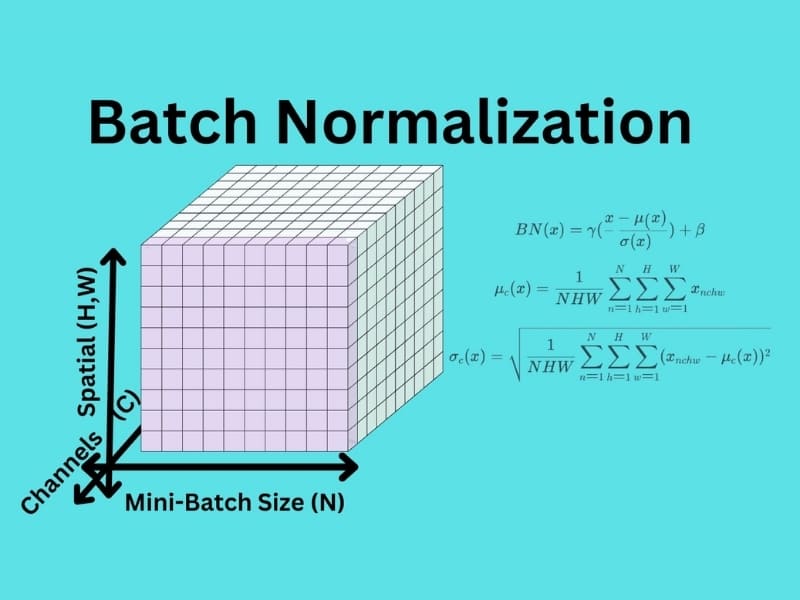
- Batch Normalization Layer: Chuẩn hóa dữ liệu giữa các lớp, giúp mô hình học ổn định và hội tụ nhanh hơn.
Các lớp này không trực tiếp thực hiện nhận diện hay phân loại hình ảnh, nhưng đóng vai trò quan trọng trong việc tối ưu hiệu suất, cải thiện độ chính xác và giúp CNN hoạt động hiệu quả trên các tập dữ liệu lớn.
Ví dụ: Trong các mô hình CNN sâu như VGG hoặc ResNet, Batch Normalization và Dropout thường được sử dụng để tăng độ ổn định khi huấn luyện và giảm nguy cơ mô hình học quá mức dữ liệu huấn luyện.
Các mô hình Convolutional Neural Network phổ biến
Các kiến trúc CNN đã liên tục được cải tiến để nâng cao khả năng xử lý và nhận diện hình ảnh. Những mô hình tiêu biểu như LeNet, AlexNet, VGG, Inception và ResNet đại diện cho các bước phát triển quan trọng của CNN qua từng giai đoạn.
LeNet
LeNet-5 là một trong những kiến trúc CNN đầu tiên và quan trọng nhất, được phát triển bởi Yann LeCun vào cuối những năm 1980. Được thiết kế chủ yếu để nhận diện chữ số viết tay trên bộ dữ liệu MNIST, mô hình này có cấu trúc đơn giản gồm các lớp tích chập xen kẽ với các lớp gộp (pooling), sau đó là các lớp kết nối đầy đủ để phân loại.
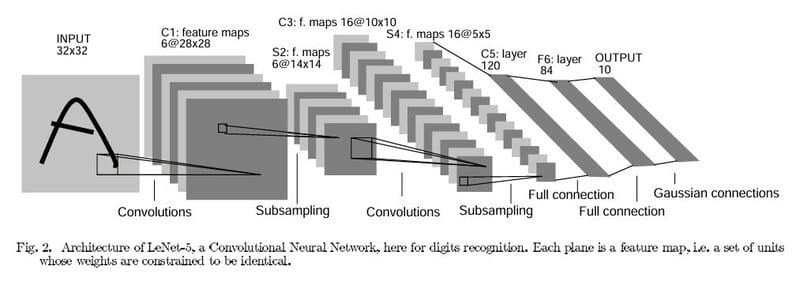
Mặc dù tương đối nhỏ so với các mô hình hiện đại, LeNet đã chứng minh hiệu quả vượt trội của CNN trong việc trích xuất đặc trưng từ hình ảnh, đặt nền móng cho mọi kiến trúc CNN sau này và đánh dấu bước ngoặt quan trọng trong lịch sử thị giác máy tính.
AlexNet
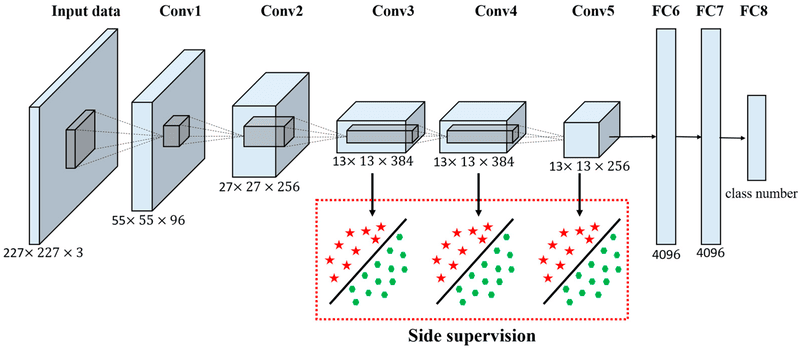
AlexNet, được phát triển bởi Alex Krizhevsky, Ilya Sutskever và Geoffrey Hinton vào năm 2012, là mô hình CNN đầu tiên giành chiến thắng trong cuộc thi ImageNet (ILSVRC) và đánh dấu sự bùng nổ của kỷ nguyên học sâu. Cấu trúc của AlexNet gồm năm lớp tích chập xen kẽ với ba lớp gộp, sau đó là ba lớp kết nối đầy đủ.
Đột phá lớn nhất của mô hình này là việc sử dụng hàm kích hoạt ReLU giúp tăng tốc độ huấn luyện đáng kể, cùng với kỹ thuật Dropout để giảm overfitting và ứng dụng GPU để tính toán hiệu quả, mở ra thời đại mới cho CNN trong nhận dạng hình ảnh.
VGGNet
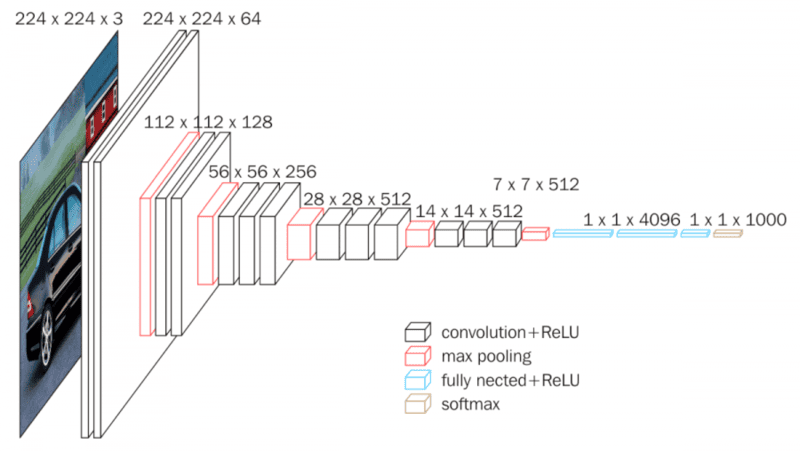
VGGNet, được phát triển bởi nhóm nghiên cứu Visual Geometry Group tại Đại học Oxford, nổi bật với thiết kế đơn giản nhưng cực kỳ hiệu quả. Mô hình này sử dụng các bộ lọc 3×3 được xếp chồng lên nhau một cách đồng nhất, với hai phiên bản phổ biến nhất là VGG-16 và VGG-19 (có 16 và 19 lớp tích chập tương ứng).
Mặc dù VGG đạt kết quả xuất sắc trong nhận diện hình ảnh, nhưng nó cũng nổi tiếng với số lượng tham số khổng lồ (khoảng 138 triệu), làm cho mô hình trở nên nặng nề về mặt tính toán nhưng vẫn được ưa chuộng vì cấu trúc đơn giản, rõ ràng và dễ hiểu.
GoogleNet (Inception)
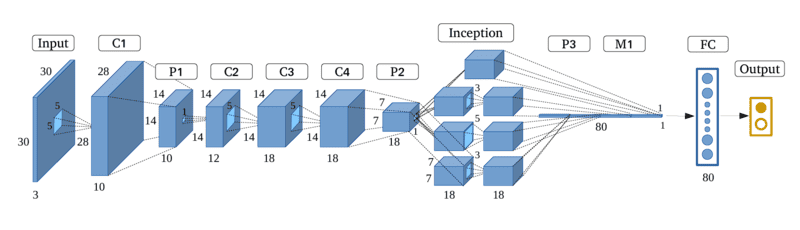
GoogLeNet (Inception v1) là kiến trúc CNN do Google phát triển, đạt thành tích dẫn đầu hạng mục phân loại ảnh tại ILSVRC 2014. Mô hình nổi bật với Inception Module, kết hợp nhiều phép tích chập và pooling song song để học đặc trưng ở nhiều quy mô. GoogLeNet có 22 lớp có tham số nhưng chỉ khoảng 5 triệu tham số, giúp tối ưu tài nguyên tính toán mà vẫn đạt hiệu quả cao trong nhận diện hình ảnh.
ResNet
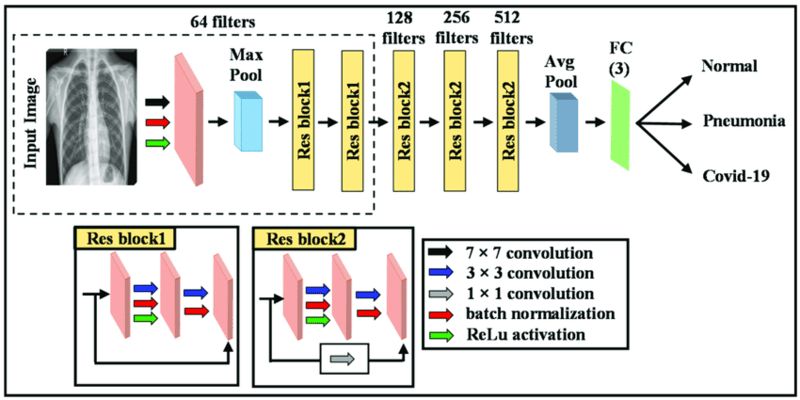
ResNet (Residual Network) là kiến trúc CNN được giới thiệu năm 2015, sử dụng skip connection để truyền thông tin qua một hoặc nhiều lớp, giúp các mạng rất sâu dễ huấn luyện và tối ưu hơn. ResNet có nhiều phiên bản như ResNet-18, 34, 50, 101 và 152.
Tại ILSVRC 2015, ensemble ResNet đạt top-5 error 3,57% trên tập kiểm thử ImageNet và giành vị trí đầu tiên ở hạng mục phân loại ảnh, trở thành một kiến trúc có ảnh hưởng lớn trong thị giác máy tính.
Lợi ích của mạng nơ-ron tích chập (CNN)
CNN nổi bật với khả năng tự động học đặc trưng và xử lý hình ảnh hiệu quả. Một số lợi ích chính gồm:
- Nhận diện hình ảnh hiệu quả: Học các đặc trưng từ đơn giản đến phức tạp, hỗ trợ phân loại và nhận diện hình ảnh.
- Tự động trích xuất đặc trưng: Giảm nhu cầu thiết kế đặc trưng thủ công.
- Hỗ trợ Transfer Learning: Tận dụng mô hình đã huấn luyện để tiết kiệm thời gian và dữ liệu.
- Giảm số lượng tham số: Cơ chế chia sẻ trọng số giúp tối ưu tài nguyên tính toán.
- Hỗ trợ tổng quát hóa: Pooling, Dropout và các kỹ thuật regularization có thể giúp hạn chế overfitting.
Ứng dụng của mạng nơ-ron tích chập trong thực tế
Nhờ khả năng tự động trích xuất đặc trưng và nhận diện hình ảnh với độ chính xác cao, Convolutional Neural Networks (CNN) được ứng dụng rộng rãi trong nhiều lĩnh vực như y tế, ô tô tự lái, mạng xã hội, thương mại điện tử và trợ lý ảo.
Y tế
Trong lĩnh vực y tế, CNN được sử dụng để phân tích hình ảnh X-quang, MRI, CT scan và ảnh mô bệnh học. Mô hình có thể phát hiện khối u trong ảnh não, xác định tổn thương phổi, hoặc đánh giá bệnh lý võng mạc do tiểu đường. Nhờ khả năng xử lý nhanh và chính xác, CNN hỗ trợ bác sĩ chẩn đoán sớm và nâng cao hiệu quả điều trị.
Ngành ô tô
CNN đóng vai trò cốt lõi trong hệ thống xe tự hành. Thông qua dữ liệu từ camera và cảm biến, mô hình có thể nhận diện làn đường, biển báo giao thông, người đi bộ và phương tiện khác. Ngoài ra, CNN còn được tích hợp trong các tính năng như cảnh báo va chạm, kiểm soát hành trình và hỗ trợ đỗ xe, giúp tăng mức độ an toàn khi vận hành.
Mạng xã hội
Các nền tảng mạng xã hội sử dụng CNN để nhận diện khuôn mặt, hỗ trợ gợi ý gắn thẻ trong ảnh. Đồng thời, mô hình cũng giúp phát hiện và lọc nội dung vi phạm như hình ảnh bạo lực hoặc nội dung không phù hợp, góp phần duy trì môi trường trực tuyến an toàn.
Thương mại điện tử
CNN cho phép người dùng tìm kiếm sản phẩm bằng cách tải lên hình ảnh thay vì nhập từ khóa. Hệ thống phân tích đặc điểm như màu sắc, hình dạng và kết cấu để đề xuất sản phẩm tương tự. Ngoài ra, CNN còn hỗ trợ cá nhân hóa gợi ý sản phẩm dựa trên lịch sử duyệt ảnh, giúp nâng cao trải nghiệm mua sắm và tăng tỷ lệ chuyển đổi.
Trợ lý ảo
Bên cạnh xử lý hình ảnh, CNN cũng được ứng dụng trong nhận diện giọng nói. Các trợ lý ảo như Google Assistant, Siri hay Alexa sử dụng CNN để phân tích âm thanh và nhận diện từ khóa chính xác hơn. Nhờ đó, hệ thống có thể hiểu lệnh người dùng, phản hồi theo ngữ cảnh và cải thiện độ chính xác trong giao tiếp.
Các tham số quan trọng khi xây dựng và huấn luyện CNN
Hiệu quả của Convolutional Neural Network không chỉ phụ thuộc vào kiến trúc mô hình mà còn chịu ảnh hưởng lớn từ cách lựa chọn các tham số huấn luyện. Việc thiết lập phù hợp giúp CNN học đặc trưng tốt hơn, tối ưu tài nguyên tính toán và cải thiện độ chính xác của mô hình.
Số lượng lớp tích chập
Số lượng lớp tích chập quyết định khả năng học đặc trưng của CNN. Các lớp nông thường phát hiện đặc trưng cơ bản như cạnh hoặc góc, trong khi các lớp sâu hơn có thể nhận diện hình dạng và cấu trúc phức tạp hơn. Tuy nhiên, mô hình quá sâu có thể làm tăng độ phức tạp huấn luyện và gây khó hội tụ.
Khuyến nghị tham khảo:
- 3–5 lớp tích chập: Phù hợp với các bài toán phân loại ảnh thông thường.
- Hàng chục đến hàng trăm lớp: Thường xuất hiện trong các kiến trúc lớn như VGG hoặc ResNet.
- Batch Normalization, Skip Connection: Nên kết hợp khi xây dựng mạng sâu để cải thiện khả năng hội tụ.
Kích thước bộ lọc – Filter Size
Kích thước bộ lọc (kernel) ảnh hưởng trực tiếp đến phạm vi quan sát và khả năng trích xuất đặc trưng của mô hình. Bộ lọc nhỏ giúp giảm số lượng tham số, trong khi bộ lọc lớn phù hợp để phát hiện các đặc trưng có phạm vi rộng hơn.
Kích thước phổ biến:
- 3×3: Lựa chọn phổ biến nhất nhờ cân bằng giữa độ chính xác và chi phí tính toán.
- 5×5: Phù hợp để phát hiện các đặc trưng lớn hơn ở những lớp đầu.
- 7×7: Thường xuất hiện trong một số kiến trúc CNN chuyên biệt.
- Nhiều lớp 3×3 liên tiếp: Thường được ưu tiên hơn một kernel lớn để giảm tham số nhưng vẫn học được đặc trưng phức tạp.
Kích thước Pooling Layer
Pooling Layer giúp giảm kích thước feature map, từ đó giảm số lượng tham số và tăng tốc độ xử lý. Việc lựa chọn kích thước pooling phù hợp giúp CNN giữ lại thông tin quan trọng mà không làm mất quá nhiều đặc trưng của ảnh.
Kích thước thường dùng:
- Max Pooling 2×2: Cấu hình phổ biến nhất trong các bài toán thị giác máy tính.
- Pooling 4×4: Có thể sử dụng với ảnh độ phân giải cao hoặc khi cần giảm nhanh kích thước dữ liệu.
- Average Pooling: Phù hợp khi cần làm mịn dữ liệu thay vì chỉ giữ đặc trưng nổi bật nhất.
- Max Pooling: Thường được ưu tiên hơn vì giữ lại các đặc trưng quan trọng hiệu quả hơn.
Thách thức và hạn chế của Convolutional Neural Network
Dù hiệu quả trong nhiều bài toán thị giác máy tính, CNN vẫn có một số hạn chế:
- Tốn tài nguyên tính toán: Các mạng CNN sâu thường cần GPU/TPU và chi phí huấn luyện lớn.
- Phụ thuộc vào dữ liệu: Dữ liệu ít hoặc thiếu đa dạng có thể làm giảm khả năng tổng quát hóa.
- Khó tối ưu: Nhiều siêu tham số cần được lựa chọn và tinh chỉnh phù hợp.
- Khó giải thích: CNN thường khó lý giải rõ nguyên nhân phía sau từng dự đoán.
- Nguy cơ overfitting: Mô hình có thể học quá sát dữ liệu huấn luyện nếu thiếu các biện pháp kiểm soát phù hợp.
Lời kết
Tóm lại, Convolutional neural network (CNNs) đã và đang đóng một vai trò quan trọng trong nhận diện và phân tích dữ liệu trực quan. Các kiến trúc CNNs như LeNet, AlexNet, VGGNet, và ResNet đã chứng minh hiệu quả vượt trội trong việc giải quyết các vấn đề về nhận diện hình ảnh. Với khả năng mạnh mẽ và tính linh hoạt, CNNs hiện đang là nền tảng không thể thiếu trong các ứng dụng như thị giác máy tính, y tế, marketing và nhiều lĩnh vực khác. Tuy nhiên, để sử dụng CNN hiệu quả, cần cân đối giữa tài nguyên, dữ liệu và chiến lược tối ưu mô hình.