vi
 en
 ja


Encoder–Decoder là kiến trúc học sâu dùng để biến đổi dữ liệu đầu vào thành đầu ra có cấu trúc, chẳng hạn dịch một câu, tóm tắt văn bản hoặc tạo chú thích ảnh. Mô hình này là nền tảng của nhiều ứng dụng hiện đại như dịch máy, chatbot, nhận dạng giọng nói và các mô hình ngôn ngữ lớn. Trong bài viết này, FPT.AI sẽ giúp bạn hiểu rõ Encoder Decoder là gì, vai trò, cấu trúc, cách hoạt động và những ứng dụng nổi bật trong thực tế!
Encoder Decoder là gì?
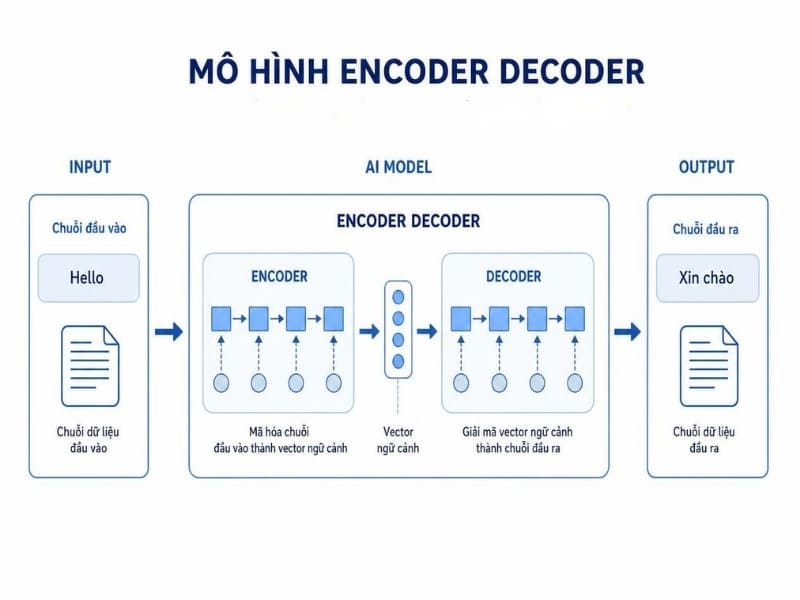
Encoder Decoder là kiến trúc mạng nơ-ron gồm hai thành phần chính: Encoder (bộ mã hóa) và Decoder (bộ giải mã). Encoder tiếp nhận dữ liệu đầu vào, trích xuất các đặc trưng quan trọng và chuyển chúng thành một biểu diễn trung gian; Decoder sau đó khai thác biểu diễn này để tạo hoặc chuyển đổi thành đầu ra phù hợp với mục tiêu của mô hình.
Encoder Decoder có vai trò như thế nào trong Machine Learning?
Encoder Decoder giúp giải quyết các bài toán mà dữ liệu đầu vào và đầu ra có cấu trúc phức tạp hoặc không giống nhau, đặc biệt là dữ liệu dạng chuỗi. Kiến trúc này cho phép mô hình duy trì ngữ cảnh và mối liên hệ giữa các thành phần dữ liệu, từ đó nâng cao độ chính xác trong các tác vụ như dịch ngôn ngữ, tóm tắt văn bản, trả lời câu hỏi hay chuyển giọng nói thành văn bản.
Ví dụ:
| Bài toán | Vai trò của Encoder | Vai trò của Decoder |
| Dịch tiếng Anh sang tiếng Việt | Mã hóa câu tiếng Anh “How are you?” thành biểu diễn ngữ nghĩa | Sinh câu tiếng Việt tương ứng “Bạn có khỏe không?” |
| Sinh chú thích cho hình ảnh | Trích xuất đặc trưng từ hình ảnh | Tạo câu mô tả như “Một chú chó đang chạy trên bãi cỏ” |
Mô hình Encoder-Decoder có kiến trúc như thế nào?
Kiến trúc Encoder-Decoder được xây dựng từ hai thành phần chính là Encoder và Decoder. Sự phối hợp giữa hai thành phần này giúp hệ thống xử lý và chuyển đổi dữ liệu cho nhiều bài toán AI khác nhau.
Encoder
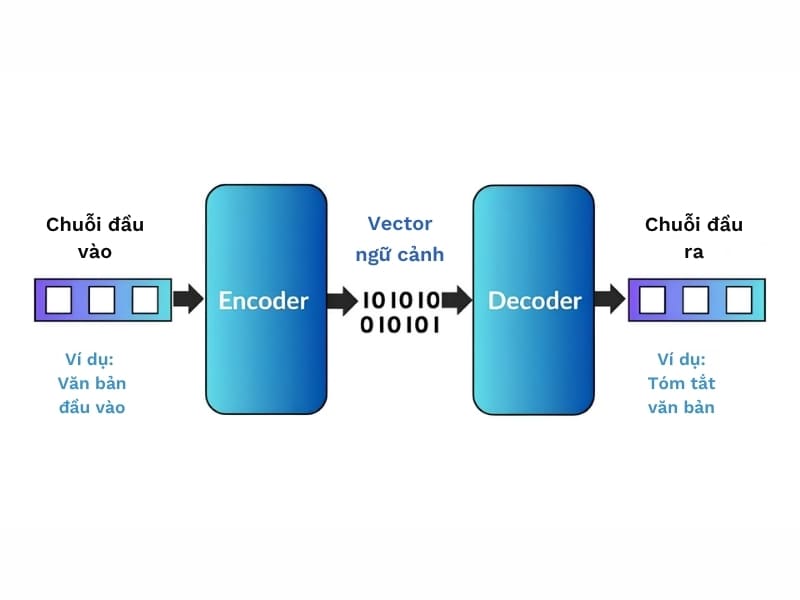
Encoder là thành phần tiếp nhận dữ liệu đầu vào và chuyển đổi dữ liệu đó thành một biểu diễn ngữ nghĩa cô đọng, thường được gọi là vector ngữ cảnh (Context Vector). Vector này lưu trữ những thông tin quan trọng nhất của dữ liệu, giúp mô hình nắm bắt được nội dung và mối quan hệ giữa các thành phần trong đầu vào.
Tùy theo đặc điểm của bài toán, Encoder có thể được xây dựng bằng nhiều kiến trúc mạng nơ-ron khác nhau như Recurrent Neural Network (RNN), Convolutional Neural Network (CNN) hoặc Transformer Model để xử lý và trích xuất đặc trưng từ dữ liệu.
Decoder
Decoder là thành phần nhận vector ngữ cảnh do Encoder tạo ra và sử dụng thông tin này để sinh ra dữ liệu đầu ra tương ứng. Quá trình giải mã giúp chuyển đổi biểu diễn trung gian thành kết quả cuối cùng phù hợp với yêu cầu của từng tác vụ.
Tương tự Encoder, Decoder cũng có thể được triển khai bằng RNN, CNN hoặc Transformer tùy theo mục tiêu ứng dụng. Thành phần này đóng vai trò diễn giải thông tin đã được mã hóa để tạo ra chuỗi văn bản, âm thanh hoặc các dạng dữ liệu khác một cách phù hợp với ngữ cảnh.
Nguyên lý hoạt động của Encoder Decoder Models
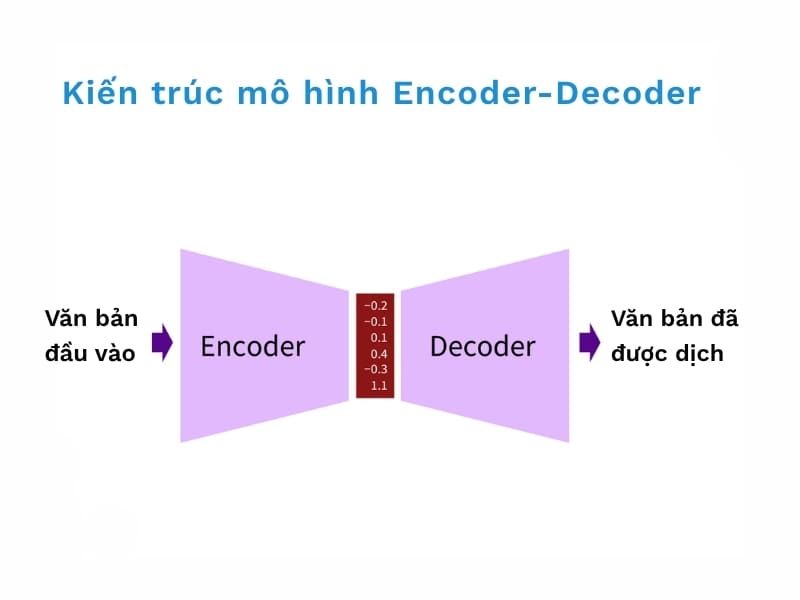
Encoder Decoder Models hoạt động theo cơ chế tiếp nhận dữ liệu đầu vào → tạo biểu diễn trung gian → sinh dữ liệu đầu ra. Hai thành phần phối hợp với nhau để giữ lại thông tin quan trọng từ dữ liệu nguồn và chuyển đổi thành kết quả phù hợp với nhiệm vụ cần xử lý.
Cách Encoder – Decoder xử lý dữ liệu
Quá trình xử lý thường diễn ra qua hai giai đoạn chính:
- Encoder tiếp nhận đầu vào: Dữ liệu như văn bản, âm thanh hoặc hình ảnh được đưa vào mô hình để phân tích.
- Mã hóa đặc trưng: Encoder trích xuất các thông tin quan trọng và chuyển dữ liệu thành biểu diễn số có chứa đặc điểm và ngữ nghĩa cần thiết.
- Decoder tiếp nhận biểu diễn: Thông tin đã được mã hóa trở thành cơ sở để Decoder xác định nội dung cần tạo.
- Sinh đầu ra: Decoder tạo kết quả theo từng bước cho đến khi hoàn thành chuỗi hoặc dữ liệu đầu ra mong muốn.
Cơ chế truyền thông tin từ Encoder sang Decoder
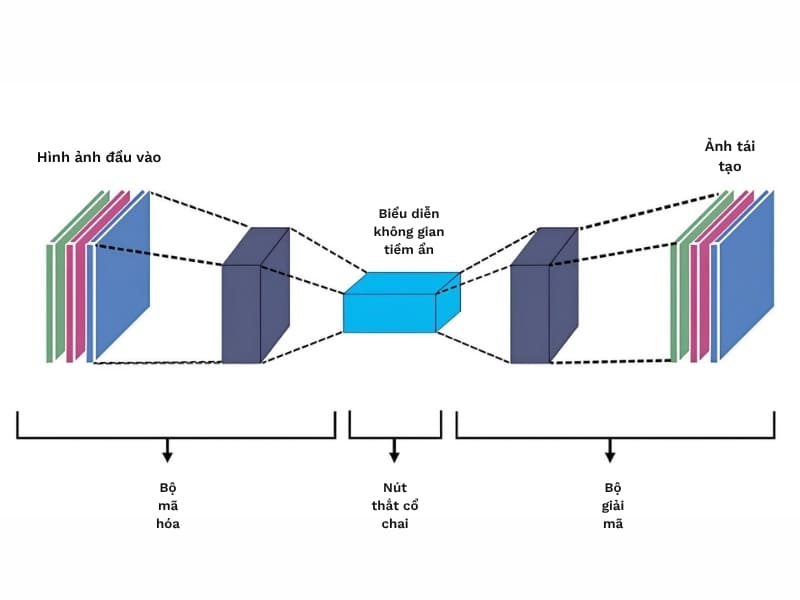
Ở các mô hình Seq2Seq truyền thống, Encoder thường tổng hợp thông tin đầu vào thành một vector ngữ cảnh, sau đó chuyển vector này cho Decoder để tạo đầu ra. Tuy nhiên, việc nén toàn bộ nội dung vào một biểu diễn duy nhất có thể làm mất thông tin khi chuỗi đầu vào quá dài.
Trong các kiến trúc hiện đại sử dụng Attention hoặc Transformer, Decoder có thể truy cập trực tiếp nhiều biểu diễn do Encoder tạo ra. Cơ chế cross-attention giúp Decoder tập trung vào những phần đầu vào liên quan nhất tại từng thời điểm sinh dữ liệu, từ đó cải thiện khả năng giữ ngữ cảnh và tạo đầu ra chính xác hơn.
Các loại Encoder Decoder Models phổ biến
Tùy vào dạng dữ liệu và bài toán cần xử lý, Encoder Decoder Models có thể được xây dựng theo nhiều kiến trúc khác nhau. Trong đó, mô hình chuỗi-đến-chuỗi và mô hình sử dụng mạng tích chập là hai dạng phổ biến.
Mô hình Encoder Decoder chuỗi-đến-chuỗi
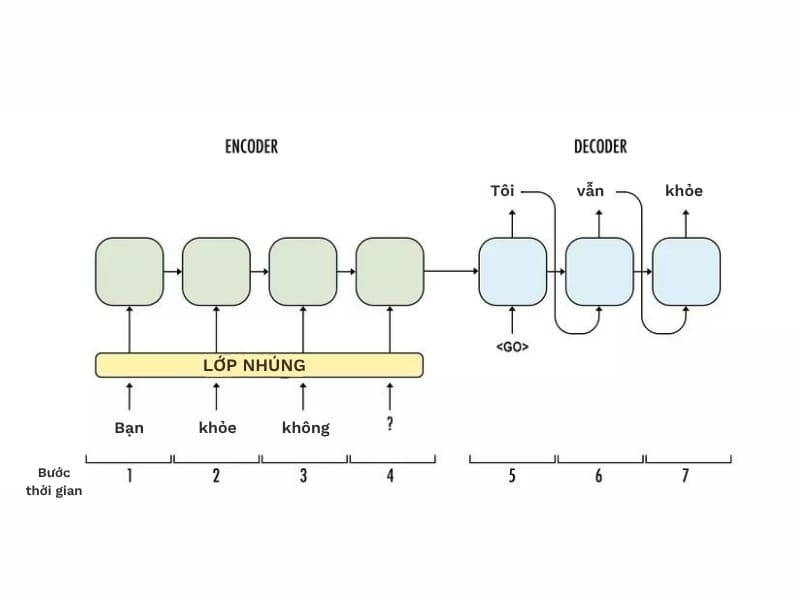
Mô hình Seq2Seq nhận một chuỗi dữ liệu đầu vào và tạo ra một chuỗi đầu ra tương ứng. Encoder chịu trách nhiệm nắm bắt thông tin của chuỗi nguồn, còn Decoder sử dụng biểu diễn đó để sinh kết quả theo từng bước. Kiến trúc này phù hợp với dịch máy, tóm tắt văn bản và xử lý giọng nói.
Mô hình Encoder Decoder sử dụng mạng tích chập
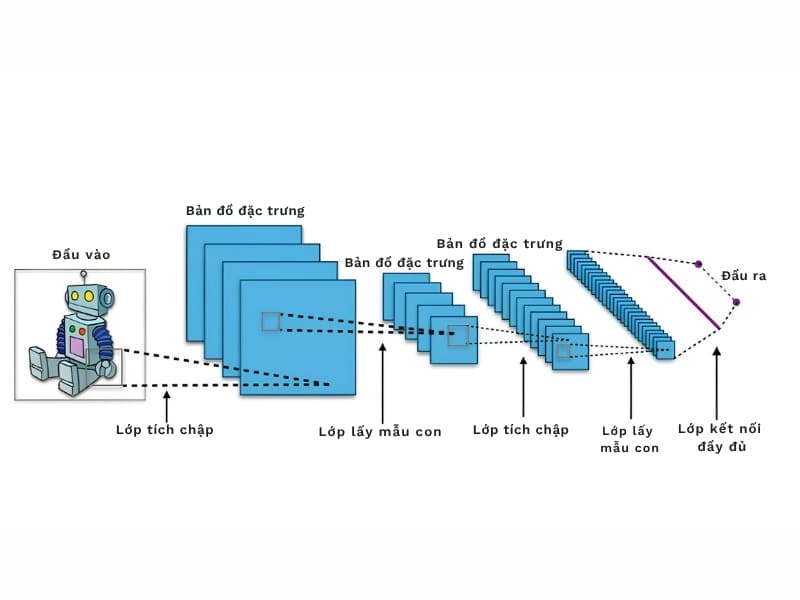
Mô hình này kết hợp CNN trong quá trình mã hóa hoặc giải mã để xử lý các đặc trưng có tính không gian. Nhờ khả năng nhận diện cấu trúc và đặc điểm cục bộ, kiến trúc này thường được sử dụng trong xử lý hình ảnh, phân đoạn ảnh và các bài toán thị giác máy tính.
Mô hình Encoder Decoder trong Transformer
Encoder dùng self-attention để tạo biểu diễn đầu vào; Decoder dùng masked self-attention và cross-attention để tham chiếu đầu ra Encoder.
Ngày nay, kiến trúc này là nền tảng của nhiều mô hình AI hiện đại như T5, BART và các hệ thống AI tạo sinh phục vụ dịch máy, tóm tắt văn bản hoặc sinh nội dung theo ngữ cảnh.
Một số ứng dụng phổ biến của mô hình Encoder Decoder
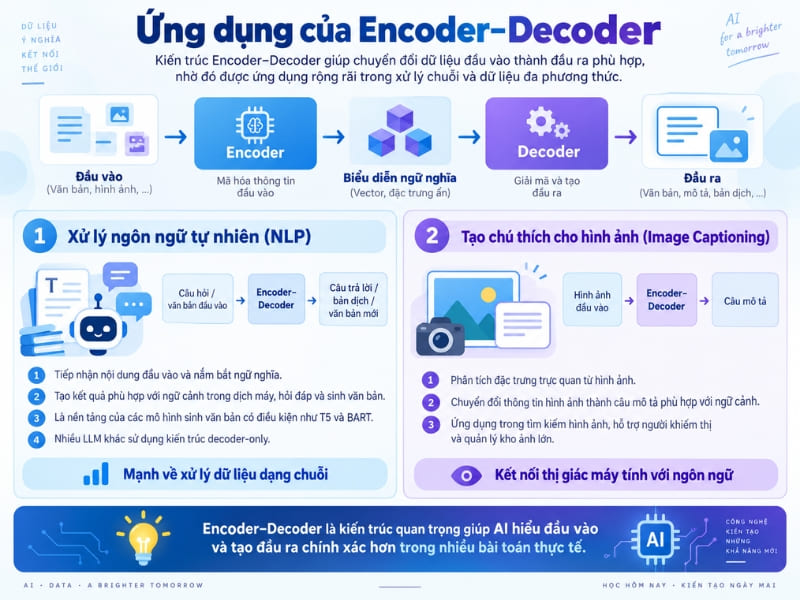
Nhờ khả năng chuyển đổi dữ liệu đầu vào thành đầu ra có cấu trúc, Encoder Decoder được ứng dụng rộng rãi trong nhiều lĩnh vực AI hiện đại.
Xử lý ngôn ngữ tự nhiên (NLP)
Trong các bài toán NLP như dịch máy, trả lời câu hỏi hoặc sinh văn bản, kiến trúc Encoder Decoder giúp hệ thống tiếp nhận nội dung đầu vào, nắm bắt ngữ nghĩa và tạo ra kết quả phù hợp với ngữ cảnh.
Nhờ khả năng xử lý dữ liệu dạng chuỗi hiệu quả, Encoder–Decoder là nền tảng của nhiều mô hình sinh văn bản có điều kiện như T5 và BART; trong khi nhiều LLM khác sử dụng kiến trúc decoder-only.
Tạo chú thích cho hình ảnh (Image Captioning)
Thông qua Encoder Decoder, các đặc trưng trực quan được phân tích và chuyển đổi thành câu mô tả phù hợp với ngữ cảnh. Nhờ đó, giải pháp này được ứng dụng trong tìm kiếm hình ảnh, hỗ trợ người khiếm thị và quản lý kho dữ liệu hình ảnh quy mô lớn.
Kết luận
Encoder–Decoder phù hợp khi đầu ra được tạo có điều kiện từ một đầu vào khác. Kiến trúc có thể triển khai bằng RNN, CNN hoặc Transformer và cần được phân biệt với encoder-only, decoder-only và Autoencoder. Nhờ khả năng nắm bắt ngữ cảnh và xử lý hiệu quả nhiều loại dữ liệu, mô hình này đã trở thành nền tảng của hàng loạt ứng dụng AI hiện đại trong NLP, Computer Vision, Speech AI và các mô hình Generative AI.