vi
 en
 ja


AI ngày nay không chỉ phân tích dữ liệu mà còn có khả năng tạo ra hình ảnh, văn bản và nhiều loại nội dung mới. Một trong những công nghệ đặt nền móng cho bước tiến này là mô hình GAN (Generative Adversarial Networks), hay mạng đối nghịch tạo sinh, sử dụng hai mạng nơ-ron Generator và Discriminator được huấn luyện theo cơ chế đối kháng để tạo ra dữ liệu mới có đặc điểm tương tự dữ liệu thực tế. Vậy mô hình GAN hoạt động như thế nào, có những loại nào và được ứng dụng ra sao trong thực tế? Cùng FPT.AI tìm hiểu nguyên lý hoạt động, ưu nhược điểm và các ứng dụng nổi bật của mạng GAN trong bài viết dưới đây.
Mạng GAN (Generative Adversarial Networks) là gì?
Mạng GAN (Generative Adversarial Networks) hay mạng đối nghịch tạo sinh là một kiến trúc Deep Learning thuộc nhóm mô hình Generative AI, được giới thiệu lần đầu vào năm 2014 bởi Ian Goodfellow và các cộng sự. Mô hình GAN sử dụng cơ chế học đối kháng giữa hai mạng nơ-ron để học các đặc trưng của dữ liệu huấn luyện và tạo ra dữ liệu mới có đặc điểm tương tự dữ liệu thực tế.
GAN hoạt động dựa trên hai mạng nơ-ron được huấn luyện theo cơ chế đối kháng:
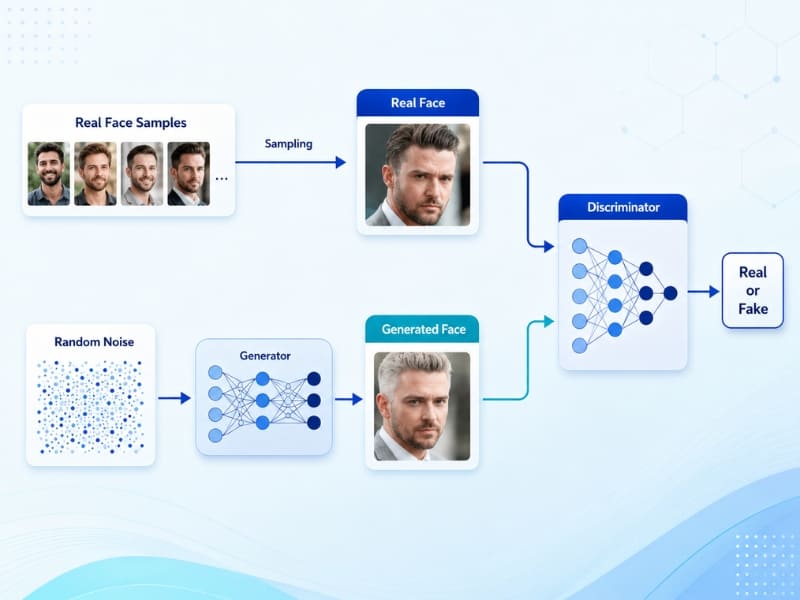
- Generator (mạng sinh): Tạo dữ liệu mới từ nhiễu ngẫu nhiên (noise hoặc latent vector) như hình ảnh hoặc âm thanh nhằm mô phỏng dữ liệu thật.
- Discriminator (mạng phân biệt): Đánh giá dữ liệu đầu vào là dữ liệu thật hay do Generator tạo ra.
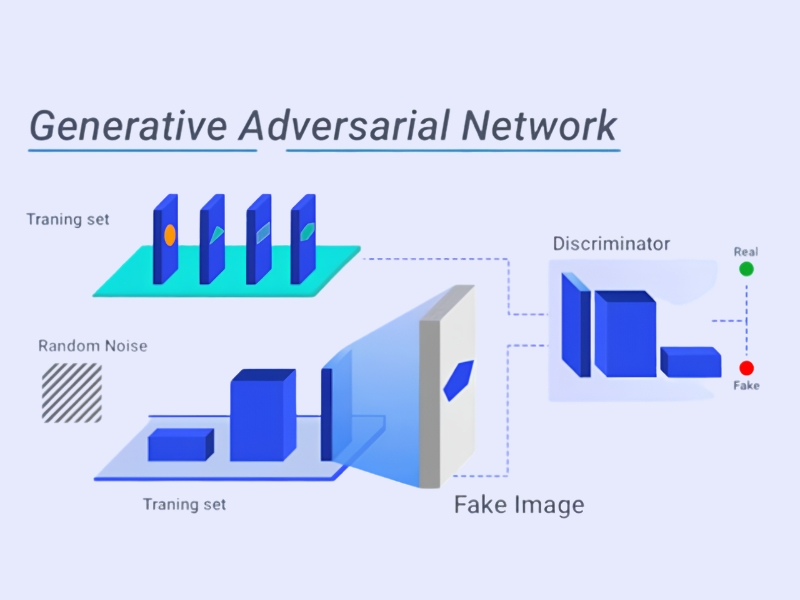
Điểm đặc trưng của GAN nằm ở cơ chế cạnh tranh giữa hai mạng. Generator cố gắng tạo dữ liệu đủ chân thực để đánh lừa Discriminator, trong khi Discriminator học cách phân biệt dữ liệu thật và dữ liệu được tạo ra. Thông qua quá trình huấn luyện đối kháng, Generator có thể học cách sinh những mẫu dữ liệu ngày càng gần với phân phối của tập dữ liệu gốc.
Ví dụ, khi huấn luyện GAN trên một tập gồm 10.000 hình ảnh mèo, Generator học các đặc trưng như hình dạng khuôn mặt, màu lông và cấu trúc cơ thể để tạo ra hình ảnh mèo mới. Các hình ảnh này không nhất thiết trùng với ảnh trong tập huấn luyện, nhưng có thể mang những đặc điểm tương tự ảnh thật.
Nhờ khả năng tạo dữ liệu tổng hợp, GAN được nghiên cứu và ứng dụng trong tạo ảnh AI, phục hồi và nâng cao chất lượng hình ảnh, chuyển đổi phong cách ảnh, tạo Synthetic Data, công nghệ Deepfake và nhiều bài toán Computer Vision.
Nguyên lý hoạt động của mô hình GAN
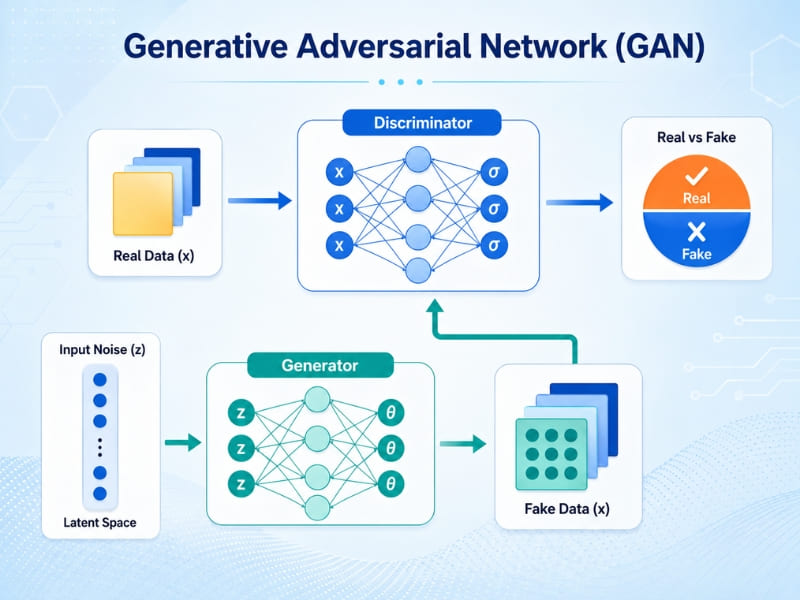
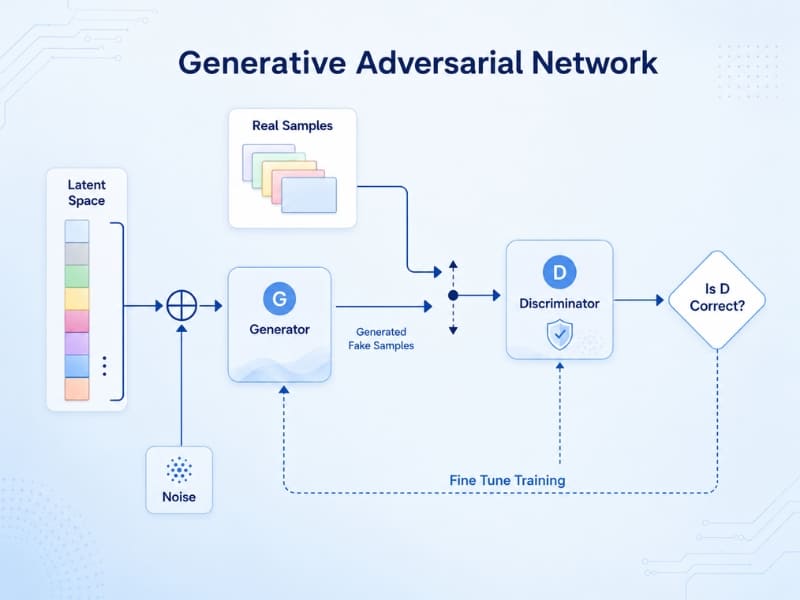
Mô hình GAN hoạt động dựa trên quá trình huấn luyện đối kháng giữa Generator và Discriminator, trong đó một mạng học cách tạo dữ liệu tổng hợp, còn mạng kia học cách phân biệt dữ liệu thật và dữ liệu giả. Thông tin phản hồi từ Discriminator được sử dụng để tối ưu Generator, giúp dữ liệu tạo ra có đặc điểm ngày càng gần với dữ liệu huấn luyện.
Quá trình hoạt động cơ bản của GAN gồm 4 bước:
Bước 1: Generator tạo dữ liệu tổng hợp
Generator nhận một vector nhiễu ngẫu nhiên (random noise vector) làm đầu vào và chuyển đổi thành mẫu dữ liệu mới, chẳng hạn như một hình ảnh. Ở giai đoạn đầu huấn luyện, dữ liệu được tạo ra thường có chất lượng thấp và chưa thể hiện rõ các đặc trưng của dữ liệu thật.
Bước 2: Discriminator phân biệt dữ liệu thật và dữ liệu giả
Discriminator tiếp nhận hai nguồn dữ liệu: mẫu thật từ tập huấn luyện và mẫu giả do Generator tạo ra. Mạng này phân tích đặc trưng của từng mẫu để đưa ra xác suất mẫu dữ liệu thuộc phân phối dữ liệu thật.
Bước 3: Hai mạng được tối ưu theo cơ chế đối kháng
Dựa trên kết quả đánh giá, Discriminator được cập nhật để phân biệt dữ liệu thật và dữ liệu giả tốt hơn. Trong khi đó, Generator được tối ưu thông qua tín hiệu lỗi truyền ngược từ Discriminator nhằm tạo ra những mẫu dữ liệu có khả năng được đánh giá là thật cao hơn.
Hai mạng có mục tiêu đối lập nhưng cùng tham gia vào quá trình cải thiện mô hình.
Bước 4: Lặp lại quá trình huấn luyện
Quá trình sinh dữ liệu, đánh giá và cập nhật tham số được lặp lại qua nhiều vòng huấn luyện. Khi quá trình tối ưu diễn ra hiệu quả, Generator có thể tạo ra dữ liệu có đặc trưng ngày càng giống dữ liệu thật, khiến Discriminator khó phân biệt hơn.
Tuy nhiên, quá trình huấn luyện GAN không phải lúc nào cũng ổn định. Nếu hai mạng học mất cân bằng, mô hình có thể gặp các vấn đề như mode collapse (Generator chỉ tạo ra một số dạng dữ liệu lặp lại) hoặc chất lượng dữ liệu sinh ra không đạt kỳ vọng.
Ví dụ về cách GAN học tạo hình ảnh khuôn mặt: Ban đầu, Generator có thể tạo ra những hình ảnh thiếu chi tiết và không giống khuôn mặt người. Discriminator nhận diện những đặc điểm bất thường này và cung cấp tín hiệu lỗi để tối ưu Generator. Qua nhiều vòng huấn luyện, Generator có thể dần học được cấu trúc khuôn mặt, vị trí mắt, mũi, miệng và các đặc trưng khác để tạo ra hình ảnh chân thực hơn.
Như vậy, GAN không tạo dữ liệu bằng cách áp dụng một bộ quy tắc cố định mà học các đặc trưng thống kê của tập dữ liệu thông qua quá trình tối ưu đối kháng giữa hai mạng neural network.
Các loại mô hình GAN phổ biến
Kể từ khi được giới thiệu vào năm 2014, GAN đã được phát triển thành nhiều biến thể nhằm cải thiện độ ổn định trong huấn luyện, giảm các vấn đề như mode collapse và đáp ứng những bài toán tạo sinh dữ liệu khác nhau. Dưới đây là 6 mô hình GAN phổ biến hiện nay.
Vanilla GAN
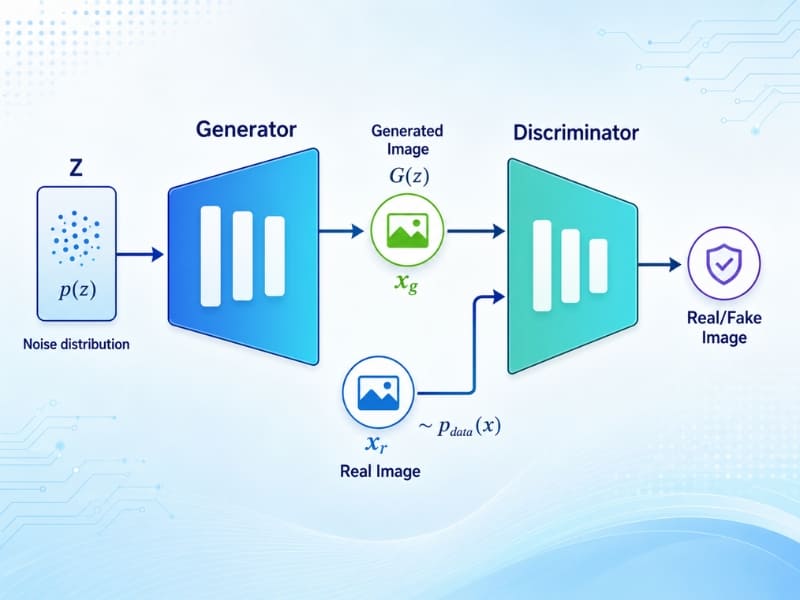
Vanilla GAN là mô hình GAN nguyên bản do Ian Goodfellow và các cộng sự đề xuất vào năm 2014. Mô hình gồm hai thành phần chính là Generator và Discriminator, được huấn luyện theo cơ chế học đối kháng. Đây là kiến trúc nền tảng của nhiều biến thể GAN được phát triển sau này.
Trong cách triển khai cơ bản, hai mạng thường sử dụng kiến trúc mạng nơ-ron truyền thẳng (Multilayer Perceptron – MLP). Generator học cách tạo dữ liệu từ nhiễu ngẫu nhiên, còn Discriminator đánh giá khả năng dữ liệu được tạo ra thuộc tập dữ liệu thực.
- Ưu điểm: Kiến trúc tương đối đơn giản, dễ triển khai đối với các bài toán tạo sinh cơ bản và đặt nền móng cho sự phát triển của các mô hình GAN.
- Hạn chế: Quá trình huấn luyện có thể thiếu ổn định, gặp hiện tượng mode collapse (tạo ra các mẫu dữ liệu thiếu đa dạng) hoặc vanishing gradients (gradient suy giảm), đặc biệt khi Discriminator trở nên quá mạnh so với Generator. Đồng thời, mô hình không hỗ trợ kiểm soát dữ liệu đầu ra theo các điều kiện cụ thể nếu không được mở rộng kiến trúc.
Conditional GAN (cGAN)
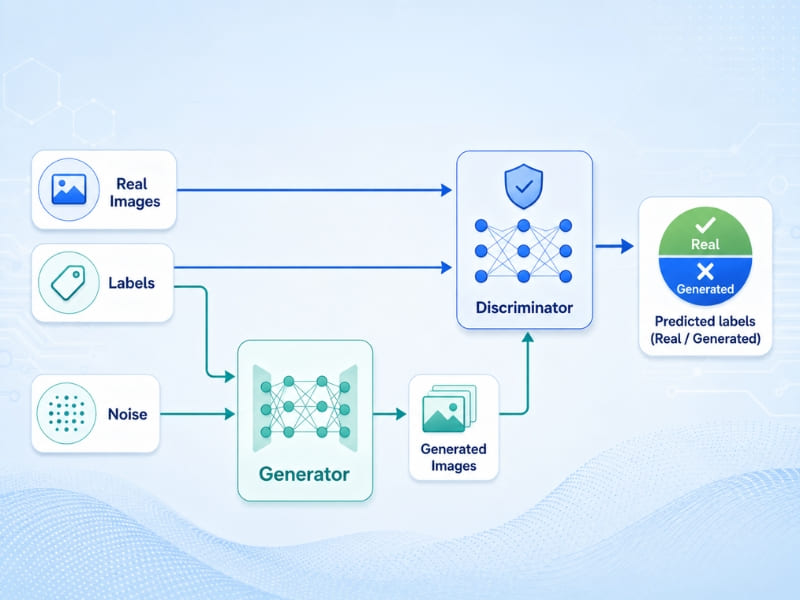
Conditional GAN (cGAN) mở rộng Vanilla GAN bằng cách bổ sung thông tin điều kiện (condition), chẳng hạn như nhãn lớp, thuộc tính hoặc dữ liệu đầu vào, vào cả Generator và Discriminator trong quá trình huấn luyện. Nhờ đó, Generator có thể tạo ra dữ liệu theo mục tiêu mong muốn thay vì sinh dữ liệu hoàn toàn ngẫu nhiên.
Khác với Vanilla GAN, cGAN cho phép định hướng kết quả tạo sinh thông qua thông tin điều kiện. Tùy theo kiến trúc và dữ liệu huấn luyện, điều kiện này có thể là nhãn phân loại, thuộc tính hình ảnh hoặc thông tin văn bản đã được mã hóa.
Ví dụ: Khi cung cấp điều kiện “nữ, tóc đen, đeo kính”, Generator có thể tạo ra hình ảnh khuôn mặt mang các đặc điểm tương ứng nếu mô hình đã được huấn luyện với dữ liệu và thông tin điều kiện phù hợp. Sau đó, Discriminator sẽ đánh giá liệu ảnh có phải là dữ liệu thật hay do Generator tạo ra và kiểm tra xem ảnh có phù hợp với các điều kiện đầu vào hay không.
- Ưu điểm: Cho phép kiểm soát nội dung dữ liệu đầu ra theo điều kiện xác định, phù hợp với các bài toán tạo ảnh theo nhãn, thuộc tính hoặc thông tin văn bản đã được biểu diễn phù hợp với kiến trúc mô hình.
- Hạn chế: Cần tập dữ liệu có nhãn hoặc thông tin điều kiện, làm tăng chi phí chuẩn bị dữ liệu trong những bài toán cần gán nhãn hoặc xây dựng cặp dữ liệu phù hợp. Ngoài ra, mô hình vẫn có thể gặp vấn đề về độ ổn định trong quá trình huấn luyện.
Deep Convolutional GAN (DCGAN)
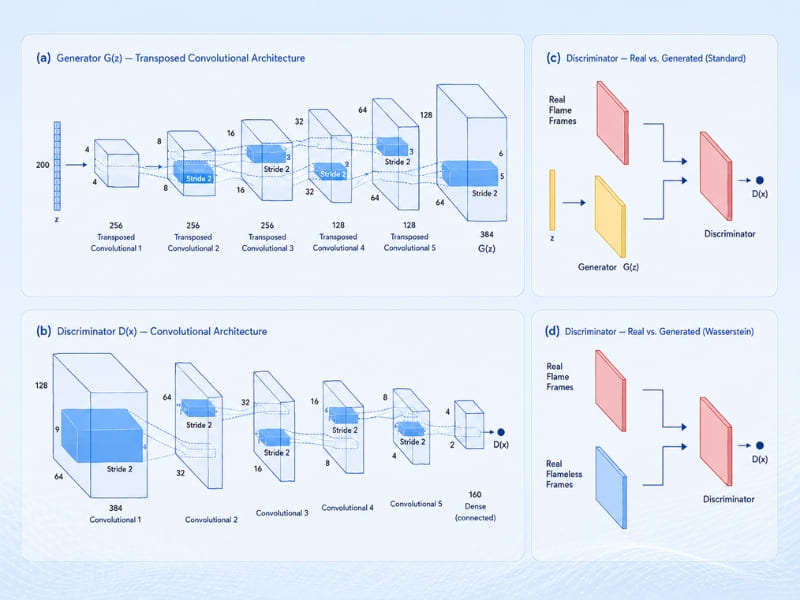
Deep Convolutional GAN (DCGAN) là biến thể của GAN sử dụng các lớp tích chập (Convolutional Layers) thay cho phần lớn các lớp kết nối đầy đủ (Fully Connected Layers) trong Generator và Discriminator. Nhờ đó, mô hình có thể học các đặc trưng không gian của hình ảnh hiệu quả hơn và cải thiện chất lượng dữ liệu được tạo ra so với một số cách triển khai GAN sử dụng mạng truyền thẳng cơ bản.
Trong kiến trúc DCGAN, Generator thường sử dụng các phép tích chập chuyển vị (Transposed Convolution) để tạo hình ảnh từ biểu diễn tiềm ẩn, trong khi Discriminator sử dụng các lớp tích chập để trích xuất đặc trưng và phân biệt ảnh thật với ảnh được tạo ra.
Ví dụ: Khi được huấn luyện trên tập dữ liệu khuôn mặt, DCGAN có thể tạo ra những khuôn mặt mới mang các đặc trưng tương tự dữ liệu huấn luyện, dù không tương ứng với người có thật ngoài đời.
- Ưu điểm: So với Vanilla GAN sử dụng mạng truyền thẳng cơ bản, DCGAN có khả năng khai thác cấu trúc không gian của hình ảnh tốt hơn nhờ các lớp tích chập, đồng thời các nguyên tắc thiết kế kiến trúc có thể giúp quá trình huấn luyện ổn định hơn. Đây là một trong những kiến trúc GAN có ảnh hưởng lớn đến sự phát triển của các mô hình sinh ảnh.
- Hạn chế: Mô hình vẫn có nguy cơ gặp hiện tượng mode collapse và hiệu quả phụ thuộc vào việc lựa chọn siêu tham số cũng như kiến trúc mạng. DCGAN cũng có thể gặp khó khăn khi tạo hình ảnh độ phân giải cao hoặc tái hiện những chi tiết phức tạp.
CycleGAN
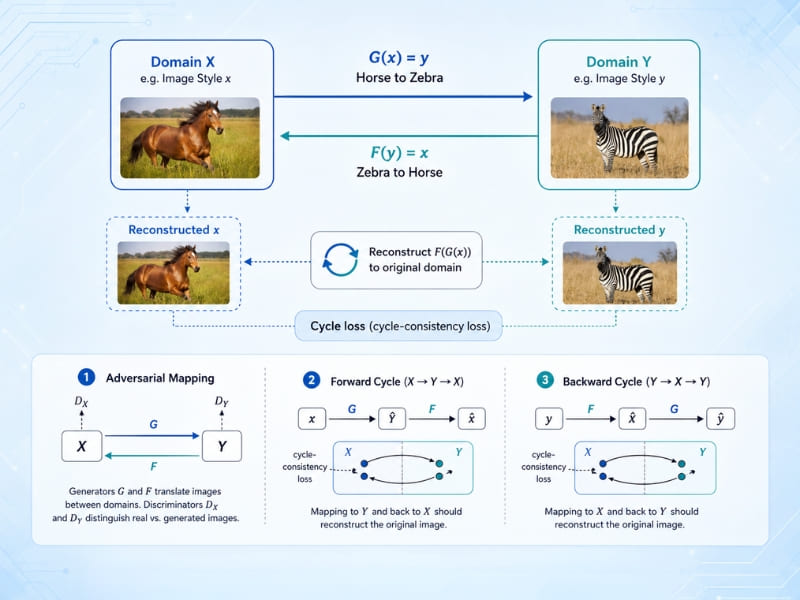
CycleGAN được thiết kế cho bài toán chuyển đổi dữ liệu giữa hai miền (image-to-image translation) mà không cần dữ liệu ghép cặp. Mô hình sử dụng hai Generator, hai Discriminator và cơ chế cycle consistency để khuyến khích dữ liệu sau khi được chuyển sang miền đích rồi chuyển ngược trở lại có thể tái tạo dữ liệu ban đầu.
Cụ thể, một Generator thực hiện chuyển đổi từ miền A sang miền B, trong khi Generator còn lại chuyển đổi theo chiều ngược lại. Hai Discriminator đánh giá mức độ tương đồng giữa hình ảnh được tạo ra và dữ liệu thật trong từng miền. Cơ chế cycle consistency giúp hạn chế việc mô hình làm mất thông tin quan trọng trong quá trình chuyển đổi.
Ví dụ: CycleGAN có thể chuyển ảnh mùa hè thành mùa đông hoặc biến ảnh ngựa thành ngựa vằn mà không cần các cặp ảnh tương ứng trong tập huấn luyện.
- Ưu điểm: Không cần dữ liệu ghép cặp, phù hợp với các bài toán chuyển đổi phong cách ảnh và chuyển đổi giữa các miền dữ liệu. Điều này đặc biệt hữu ích khi khó thu thập những cặp hình ảnh mô tả cùng một đối tượng trong hai điều kiện khác nhau.
- Hạn chế: Hiệu quả có thể suy giảm khi cần thay đổi lớn về cấu trúc hoặc hình dạng của đối tượng, đồng thời việc sử dụng nhiều mạng nơ-ron khiến quá trình huấn luyện trở nên phức tạp và có thể tiêu tốn đáng kể tài nguyên tính toán.
StyleGAN
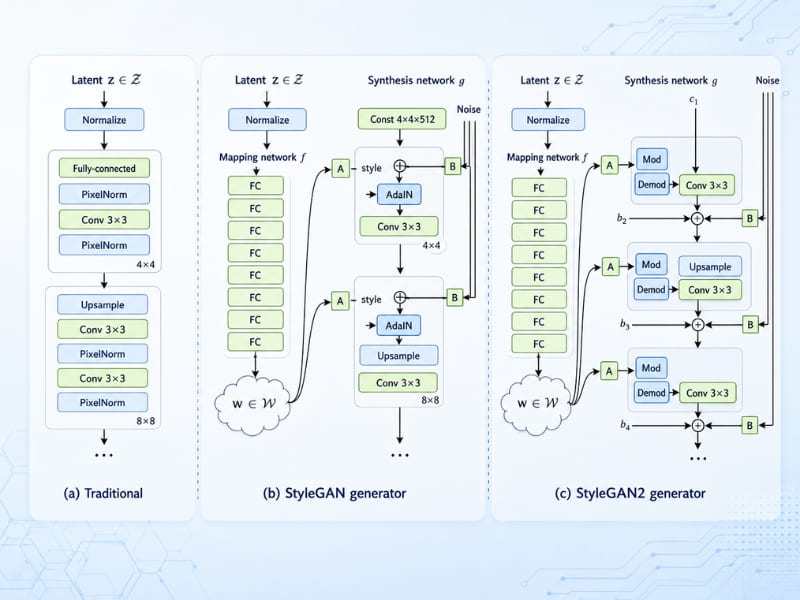
StyleGAN là một trong những biến thể GAN nổi bật với khả năng tạo ra hình ảnh có độ chân thực và chất lượng cao. Được phát triển bởi các nhà nghiên cứu NVIDIA, StyleGAN sử dụng kiến trúc Generator dựa trên phong cách (style-based generator), trong đó thông tin từ không gian tiềm ẩn được biến đổi và đưa vào các tầng của mạng sinh để điều khiển đặc trưng hình ảnh ở những mức độ khác nhau.
Mô hình cho phép kiểm soát các đặc trưng như khuôn mặt, kiểu tóc, độ tuổi hoặc biểu cảm thông qua cơ chế điều khiển phong cách (style). StyleGAN đã được cải tiến qua nhiều phiên bản, nổi bật là StyleGAN2 và StyleGAN3.
Ví dụ: Khi được huấn luyện trên tập dữ liệu khuôn mặt, StyleGAN có thể tạo ra hình ảnh của những người không tồn tại trong thực tế. Bằng các kỹ thuật thao tác trong không gian tiềm ẩn, mô hình có thể hỗ trợ điều chỉnh những đặc điểm như kiểu tóc, góc nhìn hoặc biểu cảm trong hình ảnh được tạo ra.
- Ưu điểm: Tạo ảnh có độ phân giải cao, mức độ chân thực cao trong các bài toán phù hợp và cho phép điều chỉnh nhiều thuộc tính của hình ảnh thông qua không gian tiềm ẩn.
- Hạn chế: Kiến trúc phức tạp, thường đòi hỏi tài nguyên tính toán đáng kể và thời gian huấn luyện dài, đặc biệt khi làm việc với dữ liệu hình ảnh độ phân giải cao. Việc kiểm soát chính xác từng thuộc tính cũng phụ thuộc vào mô hình và kỹ thuật thao tác được sử dụng.
Super-Resolution GAN (SRGAN)
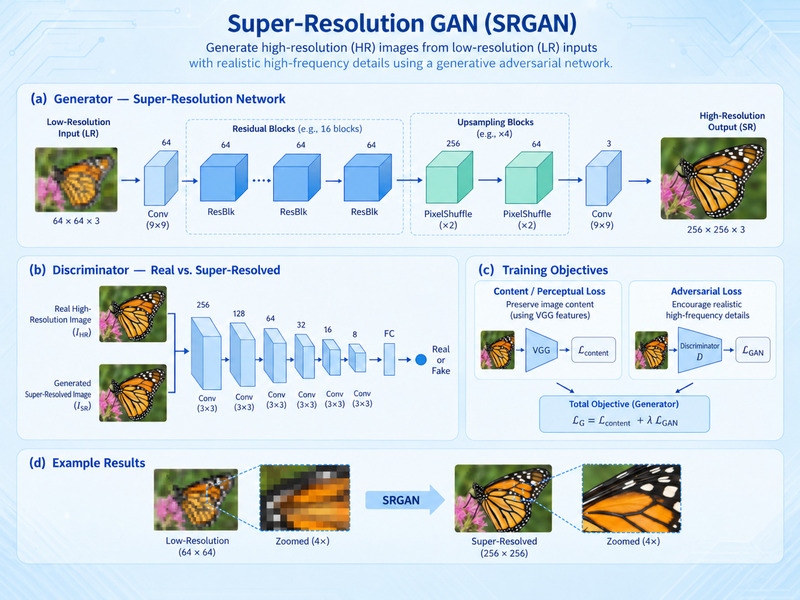
Super-Resolution Generative Adversarial Network (SRGAN) là một biến thể của GAN được thiết kế để nâng cao độ phân giải hình ảnh (Image Super-Resolution). Mô hình sử dụng Generator để chuyển đổi hình ảnh có độ phân giải thấp thành hình ảnh có độ phân giải cao hơn, trong khi Discriminator đánh giá mức độ chân thực của hình ảnh được tạo ra so với ảnh gốc có độ phân giải cao.
Điểm đặc trưng của SRGAN là kết hợp cơ chế học đối kháng với hàm mất mát cảm nhận (Perceptual Loss), giúp mô hình tái tạo các chi tiết kết cấu và tạo ra hình ảnh có chất lượng thị giác tốt hơn so với việc chỉ tối ưu sai số điểm ảnh.
Ví dụ: Khi xử lý một hình ảnh có độ phân giải thấp, SRGAN có thể tạo ra phiên bản có độ phân giải cao hơn, đồng thời tái tạo những chi tiết như kết cấu tóc, bề mặt vật thể hoặc đường nét khuôn mặt. Tuy nhiên, một số chi tiết được sinh ra có thể không phản ánh chính xác thông tin trong ảnh gốc.
- Ưu điểm: Có khả năng nâng cao độ phân giải và cải thiện chất lượng cảm nhận của hình ảnh, đặc biệt ở những vùng có kết cấu phức tạp. SRGAN phù hợp với các bài toán tăng độ phân giải ảnh và phục hồi chi tiết hình ảnh.
- Hạn chế: Các chi tiết do mô hình tạo ra có thể thiếu chính xác so với thực tế hoặc xuất hiện nhiễu, biến dạng. Hiệu quả phụ thuộc vào chất lượng dữ liệu huấn luyện, mức độ suy giảm của hình ảnh đầu vào và cách cân bằng các hàm mất mát.
Ưu và nhược điểm của Generative Adversarial Networks
Ưu điểm của mạng GAN
GAN mang lại nhiều ưu điểm nổi bật như:
- Tạo dữ liệu chân thực: GAN có thể sinh hình ảnh, âm thanh hoặc video có đặc điểm gần với dữ liệu thực tế.
- Học từ dữ liệu chưa gán nhãn: Mô hình có thể khai thác đặc trưng dữ liệu mà không phụ thuộc hoàn toàn vào quá trình gán nhãn.
- Mở rộng tập dữ liệu: Dữ liệu tổng hợp từ GAN giúp tăng độ đa dạng, hỗ trợ huấn luyện khi dữ liệu thực còn hạn chế hoặc mất cân bằng.
- Ứng dụng linh hoạt trong xử lý ảnh: GAN được dùng trong sinh ảnh, phục hồi ảnh, tăng độ phân giải, tô màu, khử nhiễu và chuyển đổi phong cách.
Nhược điểm của mạng GAN
Một số hạn chế phổ biến của GAN gồm:
- Dữ liệu thiếu đa dạng: Có thể xảy ra mode collapse, khiến Generator chỉ tạo ra một số dạng dữ liệu tương tự nhau.
- Khó huấn luyện ổn định: Generator và Discriminator cần duy trì sự cân bằng; nếu một bên vượt trội, chất lượng mô hình dễ suy giảm.
- Khó đánh giá đầu ra: Chưa có một tiêu chuẩn duy nhất phản ánh đầy đủ độ chân thực và mức độ đa dạng của dữ liệu được tạo.
- Tốn nhiều tài nguyên: GAN thường cần dữ liệu lớn, GPU mạnh và thời gian huấn luyện dài, đặc biệt với các mô hình phức tạp.
Ứng dụng thực tế của Generative Adversarial Networks
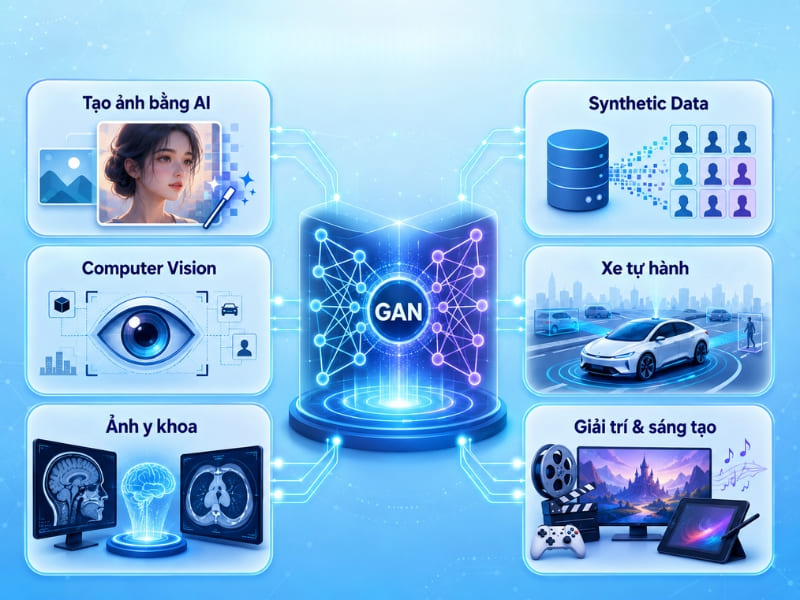
GAN được ứng dụng trong nhiều lĩnh vực nhờ khả năng tạo ra dữ liệu mới có đặc điểm tương tự dữ liệu thực tế, nổi bật gồm:
- Tạo hình ảnh: Sinh ảnh mới, chỉnh sửa hoặc nâng cao chất lượng hình ảnh.
- Tạo mô hình 3D từ dữ liệu 2D: Hỗ trợ tái dựng vật thể và không gian ba chiều từ hình ảnh.
- Tạo dữ liệu mô phỏng: Bổ sung dữ liệu huấn luyện cho mô hình AI khi dữ liệu thực tế còn hạn chế.
- Y tế và nghiên cứu khoa học: Hỗ trợ tạo dữ liệu y khoa, mô phỏng và phục vụ quá trình nghiên cứu.
- An ninh mạng và bảo mật: Mô phỏng dữ liệu hoặc các tình huống tấn công để kiểm thử và cải thiện hệ thống bảo mật.
Mô hình GAN khác các mô hình Generative AI như thế nào?
Mặc dù đều thuộc nhóm mô hình AI tạo sinh (Generative AI), GAN, VAE, Diffusion Models và LLMs được xây dựng trên những nguyên lý khác nhau và phù hợp với các bài toán riêng. Việc so sánh các mô hình này giúp hiểu rõ điểm mạnh, hạn chế cũng như lựa chọn công nghệ phù hợp với từng mục đích sử dụng.
| Tiêu chí | GAN | VAE | Diffusion Models | LLMs |
|---|---|---|---|---|
| Mục tiêu chính | Tạo dữ liệu có độ chân thực cao | Học biểu diễn dữ liệu và tạo dữ liệu mới | Sinh dữ liệu chất lượng cao bằng quá trình khử nhiễu | Sinh và xử lý văn bản |
| Cơ chế hoạt động | Hai mạng Generator và Discriminator học đối kháng | Mã hóa dữ liệu vào không gian tiềm ẩn rồi giải mã | Thêm nhiễu rồi khử nhiễu từng bước để tạo dữ liệu | Dựa trên kiến trúc Transformer, dự đoán token tiếp theo |
| Chất lượng dữ liệu đầu ra | Cao, ảnh sắc nét | Ổn định nhưng ảnh thường mờ hơn GAN | Rất cao, chân thực và đa dạng | Văn bản tự nhiên, mạch lạc |
| Tốc độ sinh dữ liệu | Nhanh | Nhanh | Chậm hơn do khử nhiễu nhiều bước | Nhanh sau khi đã huấn luyện |
| Độ khó huấn luyện | Cao, dễ mất ổn định | Thấp hơn GAN | Cao, yêu cầu nhiều tài nguyên | Rất cao, cần dữ liệu và tài nguyên lớn |
| Ứng dụng tiêu biểu | Sinh ảnh, phục hồi ảnh, Synthetic Data, Deepfake | Nén dữ liệu, sinh dữ liệu, phát hiện bất thường | AI tạo ảnh, tạo video, chỉnh sửa ảnh | Chatbot, dịch máy, tóm tắt, hỏi đáp |
Mỗi mô hình Generative AI đều có những ưu điểm riêng. GAN nổi bật ở khả năng tạo dữ liệu nhanh với chất lượng cao, đặc biệt trong các bài toán xử lý ảnh và dữ liệu tổng hợp. Trong khi đó, VAE phù hợp khi cần huấn luyện ổn định và học biểu diễn dữ liệu, Diffusion Models cho chất lượng hình ảnh vượt trội nhưng tốc độ sinh dữ liệu chậm hơn, còn LLMs được thiết kế để xử lý và tạo sinh ngôn ngữ tự nhiên.
Xu hướng phát triển của mạng GAN trong tương lai
Với khả năng tạo ra dữ liệu mới có độ chân thực cao, GAN được kỳ vọng tiếp tục phát triển và mở rộng phạm vi ứng dụng trong nhiều lĩnh vực. Một số xu hướng nổi bật gồm:
- Ứng dụng trong nghiên cứu và phát triển thuốc: GAN có thể hỗ trợ tạo và sàng lọc các cấu trúc phân tử tiềm năng, giúp các nhà nghiên cứu có thêm phương án để đánh giá trong quá trình phát triển thuốc mới.
- Hỗ trợ nâng cao chất lượng hình ảnh trong video AI: GAN có thể được kết hợp với các mô hình AI khác để cải thiện độ phân giải, bổ sung chi tiết và tăng tính liền mạch giữa các khung hình, qua đó nâng cao chất lượng video được tạo bởi AI.
- Mở rộng dữ liệu huấn luyện (Data Augmentation): GAN có khả năng sinh thêm các mẫu dữ liệu nhân tạo có đặc điểm tương đồng với dữ liệu thực, giúp đa dạng hóa tập huấn luyện, đặc biệt trong những lĩnh vực khó thu thập đủ dữ liệu như y tế, bảo mật và thị giác máy tính.
- Kết hợp GAN với các kiến trúc AI khác: Một hướng nghiên cứu là kết hợp cơ chế học đối kháng của GAN với các kiến trúc như Transformer hoặc những mô hình tạo sinh khác. Các cách tiếp cận lai này nhằm tận dụng ưu điểm của từng phương pháp để cải thiện chất lượng dữ liệu đầu ra, hiệu quả xử lý hoặc khả năng kiểm soát quá trình tạo sinh. Tuy nhiên, hiệu quả phụ thuộc vào kiến trúc và bài toán cụ thể, không phải mọi mô hình kết hợp đều vượt trội hơn GAN truyền thống.
Nhìn chung, tương lai của GAN không chỉ nằm ở việc tạo ra dữ liệu ngày càng chân thực mà còn ở khả năng giải quyết hiệu quả những bài toán chuyên biệt, đặc biệt trong xử lý hình ảnh, tăng cường dữ liệu và các ứng dụng yêu cầu kiểm soát đầu ra.
Câu hỏi thường gặp về Generative Adversarial Networks
GAN có phải Deep Learning và Generative AI không?
Có. GAN (Generative Adversarial Networks) là một mô hình thuộc Deep Learning, sử dụng hai mạng nơ-ron Generator và Discriminator để học theo cơ chế đối kháng nhằm tạo ra dữ liệu mới có đặc điểm tương tự dữ liệu thật. Đồng thời, GAN cũng thuộc nhóm Generative AI vì có khả năng tạo ra nội dung và dữ liệu mới như hình ảnh, âm thanh hoặc các dạng dữ liệu tổng hợp khác.
GAN có còn được sử dụng hiện nay không?
Có. GAN vẫn được sử dụng trong nhiều bài toán như tạo dữ liệu tổng hợp (Synthetic Data), xử lý ảnh, y tế và thị giác máy tính. Tuy nhiên, trong một số lĩnh vực như tạo ảnh AI, Diffusion Models đã trở thành lựa chọn nổi bật nhờ khả năng tạo dữ liệu chất lượng cao và đa dạng trong nhiều bài toán. Dù vậy, GAN vẫn có những lợi thế riêng, chẳng hạn như khả năng sinh dữ liệu qua một lần truyền thuận trong nhiều kiến trúc, phù hợp với những ứng dụng cần tốc độ tạo mẫu nhanh.
GAN được ứng dụng nhiều nhất trong lĩnh vực nào?
GAN được ứng dụng rộng rãi trong thị giác máy tính (Computer Vision), đặc biệt là các bài toán như tạo ảnh, tăng độ phân giải, khử nhiễu, tô màu ảnh và chuyển đổi phong cách hình ảnh. Ngoài ra, GAN còn được nghiên cứu để tạo dữ liệu tổng hợp phục vụ huấn luyện AI, xử lý ảnh y tế và mô phỏng dữ liệu trong các lĩnh vực chuyên biệt.
GAN và Diffusion Models khác nhau như thế nào?
GAN tạo dữ liệu thông qua quá trình huấn luyện đối kháng giữa Generator và Discriminator, trong khi Diffusion Models thường học cách khử nhiễu qua nhiều bước để tạo ra dữ liệu mới. GAN có thể sinh mẫu nhanh sau huấn luyện trong nhiều kiến trúc, nhưng thường gặp khó khăn về độ ổn định và tính đa dạng dữ liệu. Ngược lại, Diffusion Models có khả năng tạo hình ảnh chất lượng cao trong nhiều bài toán, song quá trình sinh dữ liệu có thể đòi hỏi nhiều bước tính toán.
>>> Tìm hiểu thêm:
Kết luận
Qua bài viết, bạn đã hiểu rõ mạng GAN (Generative Adversarial Networks) là gì, nguyên lý hoạt động, các biến thể phổ biến và những ứng dụng tiêu biểu trong thực tế. Dù vẫn còn tồn tại một số thách thức trong quá trình huấn luyện, GAN vẫn là một trong những công nghệ quan trọng của AI tạo sinh và tiếp tục được nghiên cứu, cải tiến để nâng cao hiệu quả ứng dụng.
Trong hệ sinh thái FPT.AI, GAN được ứng dụng trong việc tạo dữ liệu tổng hợp (Synthetic Data) và hỗ trợ huấn luyện các mô hình AI, góp phần giải quyết nhiều bài toán thực tiễn của doanh nghiệp trong các lĩnh vực như thị giác máy tính và xử lý dữ liệu. Liên hệ hotline 1900 638 399 để được đội ngũ FPT.AI tư vấn chi tiết về các giải pháp AI và hỗ trợ triển khai phù hợp với nhu cầu doanh nghiệp.