vi
 en
 ja


Sự phát triển của trí tuệ nhân tạo làm gia tăng nhu cầu về dữ liệu để huấn luyện mô hình. Tuy nhiên, việc thu thập dữ liệu thực thường gặp nhiều hạn chế về chi phí, quyền riêng tư và số lượng. Vì vậy, Synthetic Data đang trở thành giải pháp được nhiều doanh nghiệp lựa chọn. Trong bài viết này, FPT.AI sẽ giúp bạn hiểu rõ Synthetic Data là gì, lợi ích và các ứng dụng nổi bật của công nghệ này.
Synthetic Data là gì?
Synthetic Data (dữ liệu tổng hợp) là dữ liệu được tạo bằng thuật toán hoặc mô hình AI thay vì thu thập trực tiếp từ thực tế. Loại dữ liệu này có thể mô phỏng đặc điểm, cấu trúc và phân bố của dữ liệu thật mà không cần chứa thông tin cá nhân cụ thể. Nhờ đó, doanh nghiệp có thêm nguồn dữ liệu để phát triển và kiểm thử mô hình AI.
Trong Machine Learning, Synthetic Data thường được dùng để bổ sung dữ liệu huấn luyện, đặc biệt khi dữ liệu thực khan hiếm, nhạy cảm hoặc khó thu thập. Việc sử dụng dữ liệu tổng hợp giúp rút ngắn thời gian chuẩn bị dữ liệu, giảm chi phí và hỗ trợ bảo vệ quyền riêng tư tốt hơn.
Synthetic Data và Real Data khác nhau như thế nào?
Bảng dưới đây tổng hợp những điểm khác biệt giữa Synthetic Data và Real Data theo các tiêu chí quan trọng. Qua đó, doanh nghiệp có thể lựa chọn loại dữ liệu phù hợp với nhu cầu phát triển và huấn luyện mô hình AI.
| Tiêu chí | Synthetic Data | Real Data |
| Nguồn dữ liệu | Được tạo bằng AI hoặc các thuật toán mô phỏng | Được thu thập từ môi trường hoặc hoạt động thực tế |
| Chi phí | Thường thấp hơn khi cần mở rộng dữ liệu | Cao do phải thu thập, xử lý và gán nhãn |
| Độ chính xác | Phụ thuộc vào chất lượng mô hình tạo dữ liệu và dữ liệu tham chiếu | Phản ánh các tình huống thực tế nhưng có thể chứa nhiễu hoặc sai lệch |
| Khả năng mở rộng | Dễ tạo với số lượng lớn theo nhu cầu | Bị giới hạn bởi nguồn dữ liệu thực |
| Bảo mật dữ liệu | Giảm rủi ro lộ thông tin cá nhân | Cần tuân thủ các yêu cầu về quyền riêng tư và bảo mật |
| Khả năng tùy chỉnh | Dễ tạo theo nhiều kịch bản hoặc trường hợp hiếm gặp | Khó tùy chỉnh theo yêu cầu cụ thể |
| Tốc độ tạo dữ liệu | Nhanh, có thể tự động hóa sau khi thiết lập mô hình | Chậm do phụ thuộc vào quá trình thu thập và xử lý |
| Ứng dụng | Huấn luyện AI, kiểm thử mô hình, mô phỏng dữ liệu | Huấn luyện, đánh giá mô hình và triển khai trong môi trường thực tế |
Kết hợp dữ liệu thực với Synthetic Data đang được nhiều doanh nghiệp áp dụng trong các dự án AI. Cách tiếp cận này giúp tận dụng ưu điểm của cả hai loại dữ liệu, đồng thời tối ưu chi phí thu thập dữ liệu, nâng cao hiệu quả huấn luyện mô hình và giảm rủi ro liên quan đến quyền riêng tư.
Các loại Synthetic Data phổ biến hiện nay
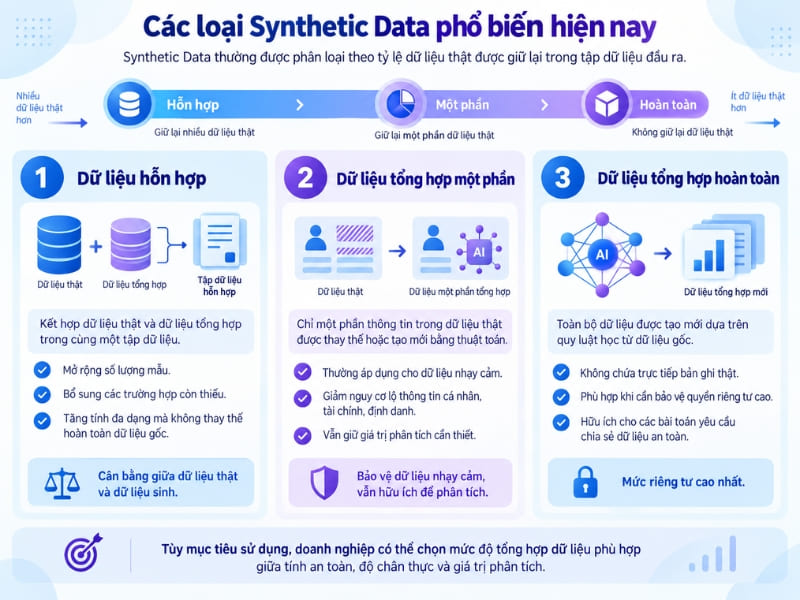
Tùy vào tỷ lệ dữ liệu thật được giữ lại, Synthetic Data có thể được chia thành ba nhóm chính:
Dữ liệu hỗn hợp
Dữ liệu hỗn hợp kết hợp giữa dữ liệu thật và dữ liệu được tạo tổng hợp trong cùng một tập dữ liệu. Cách tiếp cận này giúp mở rộng số lượng mẫu, bổ sung các trường hợp còn thiếu và tăng tính đa dạng mà không phải thay thế hoàn toàn nguồn dữ liệu ban đầu.
Dữ liệu tổng hợp một phần
Với loại này, chỉ một phần thông tin trong dữ liệu thật được thay thế hoặc tạo mới bằng thuật toán. Phương pháp thường được áp dụng cho các trường nhạy cảm như thông tin cá nhân, tài chính hoặc định danh nhằm giảm nguy cơ lộ dữ liệu nhưng vẫn giữ được giá trị phân tích.
Dữ liệu tổng hợp hoàn toàn
Dữ liệu tổng hợp hoàn toàn được tạo mới toàn bộ dựa trên các đặc điểm và quy luật học được từ dữ liệu gốc. Tập dữ liệu đầu ra không chứa trực tiếp các bản ghi thật, nhờ đó phù hợp với những bài toán yêu cầu mức độ bảo vệ quyền riêng tư cao.
Các phương pháp tạo Synthetic Data phổ biến
Hiện nay, Synthetic Data có thể được tạo ra bằng nhiều phương pháp khác nhau, từ các quy tắc đơn giản cho đến những mô hình AI hiện đại. Mỗi phương pháp sẽ phù hợp với từng loại dữ liệu và mục đích sử dụng khác nhau.
Dựa trên phân phối thống kê
Phương pháp này phân tích các đặc trưng như giá trị trung bình, độ lệch chuẩn, phân phối xác suất hoặc mối tương quan giữa các biến trong dữ liệu gốc. Từ những đặc điểm đó, hệ thống tạo ra tập dữ liệu mới có phân bố gần giống dữ liệu thực nhưng không sao chép trực tiếp từng bản ghi.
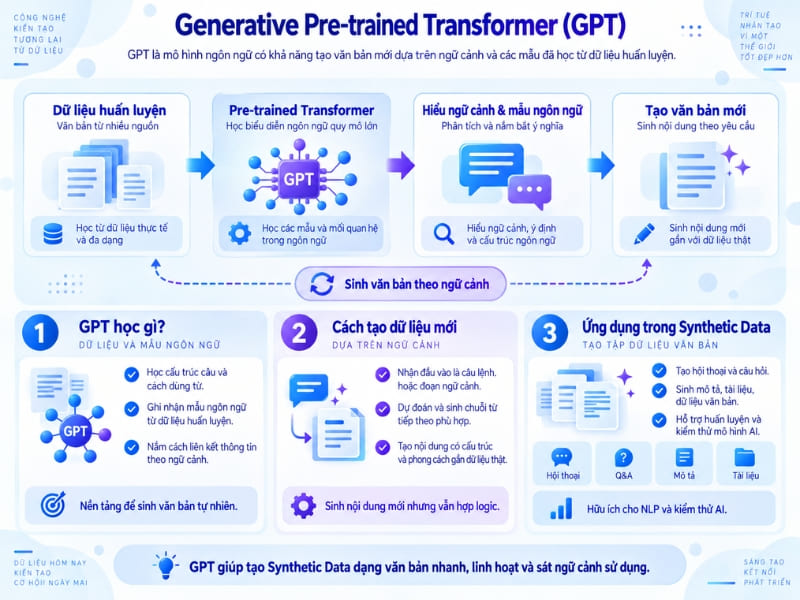
LLM và mô hình ngôn ngữ autoregressive
Các mô hình ngôn ngữ autoregressive tạo văn bản bằng cách dự đoán token tiếp theo dựa trên chuỗi nội dung đã có trước đó. Nhiều LLM hiện nay sử dụng cơ chế này để sinh văn bản có tính liên kết và phù hợp với ngữ cảnh.
Trong quá trình tạo Synthetic Data, LLM có thể được dùng để sinh hội thoại, câu hỏi, câu trả lời, mô tả hoặc các mẫu văn bản phục vụ huấn luyện, đánh giá và kiểm thử hệ thống AI. GPT là một ví dụ tiêu biểu của mô hình ngôn ngữ autoregressive có thể được ứng dụng cho mục đích này.
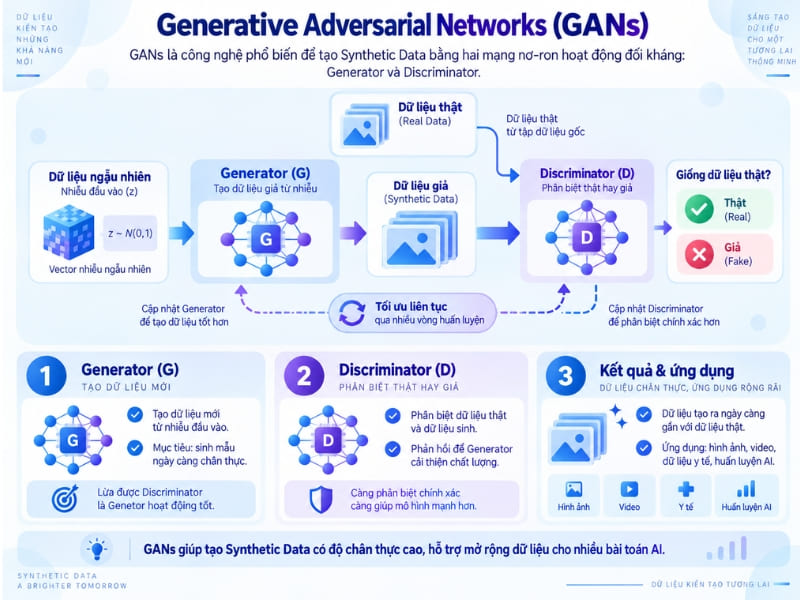
Generative Adversarial Networks (GANs)
Mạng GANs là một phương pháp tạo Synthetic Data bằng cách huấn luyện mô hình sinh ra các mẫu mới có đặc điểm gần với dữ liệu thực. Phương pháp này đặc biệt phù hợp với dữ liệu phức tạp như hình ảnh và một số loại dữ liệu mô phỏng, giúp bổ sung dữ liệu phục vụ huấn luyện, kiểm thử và phát triển mô hình AI.
Variational Autoencoders (VAEs)
Variational Autoencoder (VAE) là mô hình tạo sinh học cách biểu diễn dữ liệu trong không gian tiềm ẩn, sau đó lấy mẫu từ không gian này để tạo ra dữ liệu mới có đặc điểm tương tự dữ liệu gốc. Trong Synthetic Data, VAEs có thể được sử dụng để tạo thêm các mẫu dữ liệu như hình ảnh hoặc dữ liệu có cấu trúc, phục vụ huấn luyện và kiểm thử mô hình AI.

Lợi ích nổi bật của Synthetic Data
Synthetic Data mang lại nhiều giá trị trong quá trình phát triển, huấn luyện và kiểm thử các hệ thống AI.
- Bảo vệ quyền riêng tư: Hạn chế sử dụng trực tiếp dữ liệu cá nhân hoặc dữ liệu nhạy cảm.
- Tiết kiệm chi phí: Giảm nguồn lực cần thiết cho việc thu thập và gán nhãn dữ liệu thực.
- Bổ sung dữ liệu khan hiếm: Chủ động tạo thêm các trường hợp ít xuất hiện trong dữ liệu thật.
- Tăng tính đa dạng: Mở rộng nhiều kịch bản và tình huống phục vụ huấn luyện mô hình.
- Rút ngắn thời gian phát triển: Giúp chuẩn bị dữ liệu nhanh hơn cho các dự án AI và Machine Learning.
- Hỗ trợ kiểm thử an toàn: Tạo môi trường thử nghiệm mà không cần khai thác trực tiếp dữ liệu thật.
Hạn chế của Synthetic Data
Bên cạnh những lợi ích về chi phí, tốc độ và quyền riêng tư, Synthetic Data vẫn tồn tại một số hạn chế cần lưu ý khi ứng dụng thực tế.
- Độ chính xác chưa tuyệt đối: Dữ liệu tổng hợp có thể không phản ánh đầy đủ đặc điểm và biến động của dữ liệu thực.
- Khó mô phỏng dữ liệu phức tạp: Văn bản, hình ảnh hoặc chuỗi thời gian thường đòi hỏi mô hình tạo dữ liệu tiên tiến hơn.
- Phụ thuộc vào dữ liệu đầu vào: Dữ liệu gốc thiếu đa dạng hoặc có thiên lệch có thể ảnh hưởng đến dữ liệu được tạo ra.
- Khó kiểm chứng chất lượng: Cần đánh giá kỹ để đảm bảo dữ liệu tổng hợp phù hợp với bài toán thực tế.
- Yêu cầu chuyên môn cao: Việc xây dựng và tinh chỉnh các mô hình như GAN, VAE hoặc mô hình tạo sinh cần kiến thức chuyên sâu.
- Vẫn có rủi ro về riêng tư: Nếu thiết kế không phù hợp, dữ liệu tổng hợp vẫn có thể vô tình làm lộ thông tin nhạy cảm.
Ứng dụng của Synthetic Data trong thực tế
Synthetic Data được ứng dụng trong nhiều lĩnh vực cần lượng dữ liệu lớn, dữ liệu khó thu thập hoặc có yêu cầu cao về quyền riêng tư.
- Xe tự lái: Mô phỏng nhiều tình huống giao thông để huấn luyện và kiểm thử hệ thống lái tự động.
- Y tế: Tạo hồ sơ, hình ảnh y khoa phục vụ nghiên cứu và huấn luyện AI mà hạn chế sử dụng dữ liệu bệnh nhân thật.
- Tài chính: Mô phỏng giao dịch, hành vi tín dụng và các kịch bản rủi ro để kiểm thử mô hình.
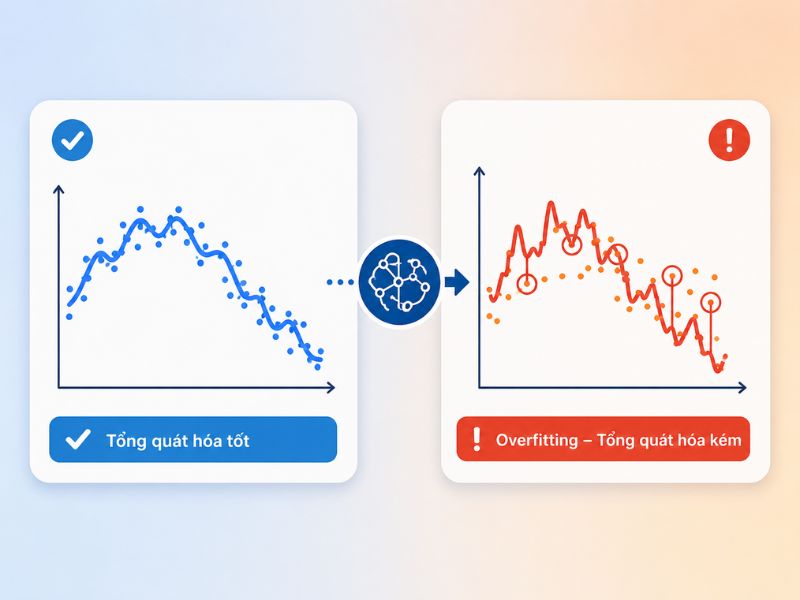
- Machine Learning: Bổ sung dữ liệu huấn luyện, cân bằng tập dữ liệu và cải thiện khả năng tổng quát hóa của mô hình.

Các công cụ tạo dữ liệu tổng hợp phổ biến hiện nay
Doanh nghiệp có thể lựa chọn nhiều nền tảng khác nhau để tạo Synthetic Data phục vụ huấn luyện AI, kiểm thử và bảo vệ dữ liệu nhạy cảm.
| Công cụ | Đặc điểm chính |
| Datomize | Tạo dữ liệu tổng hợp từ hệ thống dữ liệu phức tạp, phù hợp tài chính và ngân hàng. |
| Mostly AI | Tạo dữ liệu có đặc điểm gần dữ liệu thật nhưng giảm rủi ro lộ thông tin cá nhân. |
| Synthesized | Hỗ trợ tạo và quản lý dữ liệu cho phát triển phần mềm, phân tích và Machine Learning. |
| Hazy | Tập trung vào dữ liệu nhạy cảm và các yêu cầu cao về quyền riêng tư. |
| Gretel | Tạo dữ liệu tổng hợp phục vụ huấn luyện AI, kiểm thử và chia sẻ dữ liệu. |
| Rendered.AI | Chuyên tạo dữ liệu mô phỏng cho Computer Vision, robot, xe tự hành và ảnh vệ tinh. |
Xu hướng phát triển của Synthetic Data trong tương lai
Synthetic Data được dự đoán sẽ tiếp tục mở rộng khi nhu cầu về dữ liệu chất lượng cao và an toàn ngày càng tăng.
- Tăng cường quyền riêng tư: Giảm phụ thuộc vào dữ liệu thật và hạn chế rủi ro lộ thông tin nhạy cảm.
- Bổ sung dữ liệu huấn luyện: Hỗ trợ tạo thêm mẫu khi dữ liệu thực khan hiếm hoặc khó thu thập.
- Kết hợp với mô phỏng: Tạo nhiều kịch bản nhân tạo để huấn luyện và kiểm thử AI trong môi trường an toàn.
- Mở rộng trong NLP và Computer Vision: Cung cấp dữ liệu phục vụ huấn luyện mô hình ngôn ngữ và thị giác máy tính.

Câu hỏi thường gặp về Synthetic Data
Synthetic Data có thay thế hoàn toàn dữ liệu thực không?
Không. Trong hầu hết trường hợp, Synthetic Data được sử dụng để bổ sung thay vì thay thế hoàn toàn dữ liệu thực. Dữ liệu thực vẫn đóng vai trò quan trọng trong việc phản ánh các tình huống thực tế, đánh giá mô hình và kiểm chứng chất lượng. Việc kết hợp cả hai loại dữ liệu thường mang lại hiệu quả tốt hơn cho quá trình phát triển AI.
Synthetic Data có hợp pháp không?
Có. Synthetic Data được xem là hợp pháp nếu quá trình tạo và sử dụng dữ liệu tuân thủ các quy định về bảo vệ dữ liệu và quyền riêng tư tại từng quốc gia hoặc khu vực. Tuy nhiên, doanh nghiệp vẫn cần đánh giá chất lượng dữ liệu và đảm bảo dữ liệu tổng hợp không làm lộ hoặc có thể suy luận ngược ra thông tin của cá nhân trong dữ liệu gốc.
Synthetic Data có an toàn cho quyền riêng tư không?
Synthetic Data có thể giúp giảm rủi ro liên quan đến quyền riêng tư vì dữ liệu được tạo mới thay vì sao chép trực tiếp dữ liệu thực. Tuy nhiên, mức độ an toàn còn phụ thuộc vào phương pháp tạo dữ liệu và quy trình đánh giá. Doanh nghiệp nên áp dụng các biện pháp kiểm thử để đảm bảo dữ liệu tổng hợp không tiết lộ thông tin nhạy cảm từ dữ liệu tham chiếu.
Ngành nào sử dụng Synthetic Data nhiều nhất?
Synthetic Data được ứng dụng trong nhiều lĩnh vực, đặc biệt là AI và Machine Learning, Computer Vision, xe tự hành, y tế, tài chính – ngân hàng và an ninh mạng. Ngoài ra, dữ liệu tổng hợp cũng đang được sử dụng ngày càng nhiều trong sản xuất, bán lẻ, robot, viễn thông và các lĩnh vực cần lượng dữ liệu lớn để huấn luyện hoặc kiểm thử mô hình AI.
>>> Tìm hiểu thêm:
Kết luận
Sự phát triển của AI đang làm gia tăng nhu cầu về nguồn dữ liệu chất lượng cao, trong đó Synthetic Data ngày càng khẳng định vai trò quan trọng trong việc mở rộng tập dữ liệu, tối ưu chi phí và bảo vệ quyền riêng tư. Khi được kết hợp hợp lý với dữ liệu thực, Synthetic Data sẽ góp phần nâng cao hiệu quả huấn luyện và triển khai các mô hình AI trong nhiều lĩnh vực.
Liên hệ ngay FPT.AI qua hotline 1900 638 399 để được tư vấn giải pháp AI phù hợp với nhu cầu của doanh nghiệp và nhận hỗ trợ từ đội ngũ chuyên gia trong quá trình triển khai!